
2026 年 11 月 13 日,Google Research 的 Vahab Mirrokni 發布了〈Advancing science & engineering with Antigravity’s /teamwork〉,彙整 Antigravity /teamwork 的近期研究與工程成果。這篇最值得追問的問題是:當 AI 團隊能提出長篇證明、改寫底層程式,我們憑什麼相信交出來的答案?
先看報告如何把探索與驗收接起來,再分開檢視數學證明和效能數字,最後判斷這種工作方式值得移植到哪些任務。本文查閱日期為 2026 年 11 月 16 日;數學與解碼器結果各自依下文所列的作者產物與 Google 回報判讀。
一、Antigravity /teamwork 的核心:讓答案接受另一套檢查
All of this work is done in collaboration with human experts
中文:這些工作全部都與人類專家合作完成。
Google Research,原文導言節錄
原文涵蓋數學、形式化驗證、分子結構推斷、因果評測、系統與核心程式最佳化,也列出 Google 內部基礎設施案例。串起這些工作的主線,是由人設定問題與約束,讓 Agent 搜尋候選解,再以證明檢查器、既有測試或實體硬體回饋淘汰錯誤。產生更多候選,和更可靠地選出答案,是兩份工作。
這個設計有更完整的研究脈絡。Stellar Colosseum 論文把長程研究拆成策略探索、準備程度檢查、相依子問題與回饋修正;作者說它已整合為 Teamwork 的 Long Proof pattern。這能解釋為什麼「多開幾個聊天視窗」還不足以描述這套系統:關鍵在候選之間如何被攻擊、整理與重新組裝。
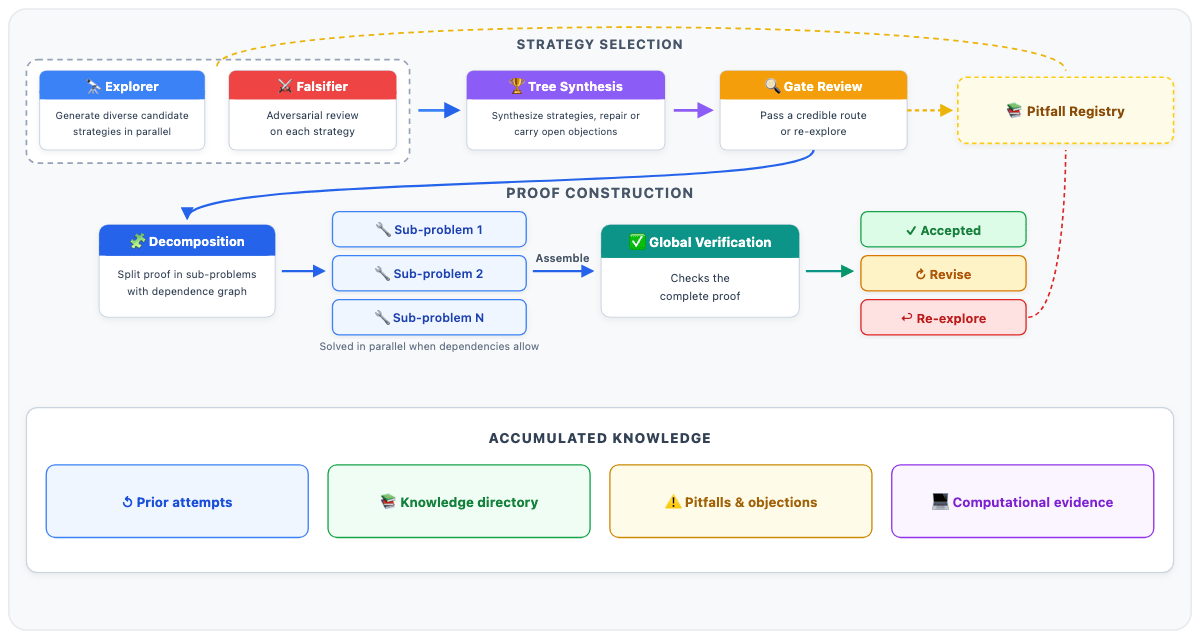
圖上半部先讓 Explorer 提案、Falsifier 找漏洞,再整合策略與檢查可行性;中段依相依關係拆解證明,最後回到完整論證驗證;下方則保存過往嘗試、陷阱與計算證據。值得注意的是那條返回探索的路:驗收失敗,應該回頭改方法,而非只把答案換一種說法。想先理解這層執行系統,可讀 Agent Harness 的模型與工作台分工。
二、Courtade–Kumar:有公開證明產物,也有人類提供的關鍵橋梁
Courtade–Kumar 問題可以先想成一串公平的隨機位元,通過會獨立翻轉位元的噪音通道。若把原始輸入濃縮成一個位元,哪種規則最能保留它與帶噪輸出之間的資訊?2013 年原始論文提出的猜想,是任何布林規則都無法勝過直接抄其中一個輸入位元的 dictator function。這裡的 dictator 是數學術語,意思是一個座標決定輸出。
Chen 等人的預印本在 2026 年 9 月 21 日提交 v1、9 月 24 日更新 v2,主張給出完整的電腦輔助證明,並將數值憑證一併端到端形式化。因此,11 月 13 日應被讀成 Google 的成果彙整日期,不能把全部發現都改寫成當天才發生。
這份成果比一則成功宣告更具體。作者公開的 Lean 程式庫列出最終命題、固定的 Lean 與 Mathlib 版本、公理檢查與重建說明。其 README 回報完整驗證約需 1,200 CPU 小時,並要求大量記憶體與磁碟空間;這次未在本機重建該證明。可檢查產物的存在提高了可稽核性,卻不能直接代替每一位讀者自己的驗證。
Both human and AI contributions were critical to this work.
中文:人類與 AI 的貢獻,對這項工作都至關重要。
Courtade–Kumar 論文,第 4 部分
論文的 人機協作說明把分工寫得很清楚:中大團隊提供關鍵候選函數、把問題化成 14 變數最佳化,並給出一項主要下界;AI 承擔大量區域切分、理論推導與區間運算。作者也描述部分階段可在無人工介入下推進。局部自主與整體合作可以同時成立;把其中一段放大成全程無人參與,就改變了成果的意思。
三、Lean 驗證到底保證什麼?先讀命題,再讀綠燈
Lean 官方驗證文件明確區分兩件事:某個形式命題是否有有效證明,以及這個形式命題究竟代表什麼。檢查器依定義、引用的定理與公理驗收推導;人仍要核對形式敘述是否忠實表達原問題,也要檢查依賴中有沒有額外公理或未完成證明留下的假設。
可以用考卷來理解:自動閱卷能嚴格確認每一步符合考卷規則,但還要有人確認題目沒有被偷偷換掉。這不是在指控上述證明有問題,而是在說明「通過檢查」的精確範圍。作者庫把最終命題與公理檢查公開,正是讓別人有機會核對這道邊界。
同樣地,「把已有的非形式證明轉成 Lean」和「首次發現一個新數學結果」應分開報。前者能大幅改善可檢查性,後者增加新的數學知識;兩者都重要,衡量的貢獻卻不同。原報告橫跨新結果與既有證明形式化,讀者不宜把整張清單都當成同一種突破。
四、Deque 的進展:上界變好了,終點仍要按公式判斷
另一個容易被轉述過頭的案例,是 Tarjan 的 Deque Conjecture。對 splay tree 的雙端插入、刪除操作,原猜想追求線性總成本。作者公開論文與 Lean 專案列出的新旋轉次數上界是 O((m+n) α_ω(m+n))。
這裡 m 是操作數、n 是初始元素數,α_ω 是一個增長極慢的函數。即使額外因子長得再慢,寫下來的定理仍與 O(m+n) 不同。因此可說這是很強的上界改善,卻不能把這個結果寫成原猜想已完整解決。有 Lean 證明的,是那個實際寫出的命題。這個例子也說明,辨認成果等級,有時比記住 Agent 開了多少個更重要。
五、Rust 解碼器快 20–30%:效能成績要帶著測試條件走
在系統工程部分,Google 回報把 AV1 解碼器 libgav1 移植到 Rust:起初約慢四倍,經效能剖析與最佳化後,在其測試影片及 x86_64、ARM 上,比原 C++ 與手工最佳化組合語言版本快 20–30%。這是 Google 對該次移植實驗的回報,不是本文完成的重測,也不是 Rust 語言普遍勝過 C++ 的證據。
原文連到的 libgav1 上游專案提供 AV1 解碼器、建置選項與測試說明。這足以查清它是哪個元件,但本次取得的資料不足以獨立重建上述 Rust 效能比較;因此本文保留公司歸因與測試範圍,不把這個數字提升成獨立驗證結論。
這段故事真正可借用的地方,是把「正確移植」與「跑得夠快」拆成兩個門檻。第一道先比對輸出與測試;第二道再看剖析、資料路徑、硬體與輸入分布。若只報最終百分比,就看不到從一個較慢但可檢查的版本,逐步變成更好版本的工程過程。
而且通過一套測試,支持的是該套測試覆蓋到的行為;效能比較也應保存影片集合、編譯器、旗標、執行緒、硬體與重複次數。這些是判讀或重做比較時應要求的證據,並非本文替 Google 補寫的實驗設定。
六、科學與基礎設施案例,為何不能共用一張成績單?
Google 還報告分子結構推斷、因果任務建構、圍棋最佳化、分散式圖運算與內部基礎設施改善。這些例子展示同一類搜尋迴圈可以接上不同檢查方式;它們的成功標準卻各有範圍。模擬光譜接近資料,還要面對候選分子是否唯一;遊戲中贏棋,驗收的是規則內的對局;公司內部節省資源,則需要明確的基準與部署範圍。
評估本身也有成本。DuoDiscover 原始論文把快速代理評估器稱為 yardstick:先用便宜的近似評分篩候選,再持續以真實評估檢查排序是否偏移。作者特別指出搜尋會利用代理指標和真正目標之間的落差。這個限制反而是研究中值得重視的訊息:便宜的尺能加快搜索,也需要定期校準。
因此,一個驗證者 Agent 說「合理」,與硬體計時器、形式證明核心給出的訊號,應該分別看待。前者可以發現值得追查的問題;後兩者也有各自的命題、輸入與測量邊界。判斷可靠性時,先問「它量的是什麼」,再問「誰說它通過」。
七、AlphaLab 的判讀:研究能力正移向可反駁的工作流程
我同意:驗收能力會決定長程搜索能走多遠
模型一次提出的解答未必完整,這不妨礙它在多次嘗試中提供有用的候選。真正能讓搜尋累積的,是錯誤能被定位、好結果能被保存、失敗不會被下一輪當成前提。Antigravity /teamwork 這份報告最有分量的訊號,是研究敘事開始附帶可查的命題、測試與程式產物,而不只是展示回答看起來多有說服力。
我存疑:成功案例還不足以估計一般團隊的投資報酬
要判斷能否搬進自己的研究室或工程團隊,還要知道失敗的任務、總搜索預算、人工介入與驗收成本。大型機構能負擔的算力與專家審核,不應直接變成每位使用者都可期待的交付條件。Google 同時提供模型與開發平台,有展示成果的商業動機;這個背景提醒我們追問分母,不能拿來直接否定公開的證明產物。
真正的轉折,可能在「什麼工作變得值得嘗試」
若檢查一個候選比創造一個候選便宜,而且檢查與目標貼近,就有機會用更多搜索換到進展。相反地,若每個候選都要昂貴實驗、長期臨床或大規模部署才知道好壞,增加 Agent 數量也會同步放大驗收成本。這是從工作流程推得的判斷,不是這篇報告已證明的通用生產力定律。
八、接下來看什麼:把發布願景變成三份可核對的證據
原文希望把研究工作流帶到外部研究者與開發者手中。查閱時,目前的 /teamwork 文件已列出付費方案、專職角色、里程碑與不同執行路線;11 月報告末段仍把形式證明等專門流程描述為後續更新。文件中的一般數學路線,不能自動等同研究展示所用的全部配置。
後續最值得追三件事。第一,公開產物能否由不同環境重建,且命題、測試與版本一致;第二,在事先選定的新任務上,成功、失敗與人工時間能否一起交代;第三,工具開放後,外部使用者是否能取得相應配置、用量與過程紀錄。這三份證據,分別回答可信、可轉移與可取得。
如果你想今天就借用這個觀念,先挑一個已有答案本的小任務:凍結原測試與基準,讓一份候選接受另一個獨立流程檢查,並把每次失敗留下來。要練分工,可讀 Actor、Judge、Teacher 的不同考卷;要把紀錄接成系統,可讀 最小 Agent Harness 實作;若評分會影響後續學習,則可接著看 保留樣本與經驗銀行驗收。
接著閱讀
左右滑動查看更多推薦
 內容類型:文章
Gemini 4 Hydrogen 解讀:四種思考檔位,怎麼看速度、成本與 Agent 成績?(2026)
Hydrogen 的快,來自模型、思考深度,還是整套 Orchestrator?拆開 Google 自報的 19% 與 24%、百萬共用視窗及外部評測,判斷哪種配置值得先試。
閱讀文章 內容類型:文章
Gemini 4 Carbon 解析:綜合榜首、程式 Agent 與受限開放,該怎麼判讀?(2026)
Gemini 4 Carbon 登上 AA 綜合能力榜首,程式 Agent 評測卻仍落後 Opus 5.5。拆開兩個 59 分、資安測試與受限開放,判斷何時值得測試與遷移。
閱讀文章 內容類型:文章
Gemini 4 Carbon 擴大開放:API 限時價、Ultra 與 /swarm 預覽怎麼看?(2026)
Carbon 開放付費 API 與 Ultra,/swarm 同步預覽。拆開 11 月優惠、12 月正式費率、外部任務成績與多 Agent 分工,判斷哪些工作值得先試。
閱讀文章 內容類型:文章
Project Suncatcher 回傳 Gemma 俳句:在軌 TPU 究竟證明了什麼?(2026)
Google 報告在軌 TPU 執行 Gemma 4 並回傳俳句。沿著發射、健康狀態、推論與互連四段證據,分清這次展示的進展,以及可靠服務還要交出的測試。
閱讀文章 內容類型:文章
Gemini Co-Scientist 深度解析:從假設走進實驗,AI 科學家真的閉環了嗎?(2026)
Gemini Co-Scientist 把假設生成接到材料、生物與醫療評測;本文核對一次生長、HealthBench、人類評估與論文幻覺,拆出真正閉環與仍由人承擔的部分。
閱讀文章 內容類型:文章
AlphaProof Code 解讀:AI 證明 Signal 安全,到底驗證了什麼?(2026)
DeepMind 用 AI 為 Signal 程式碼產生形式證明。從五人四週、650 萬行 Lean,到抗量子與執行環境的界線,讀懂這次研究真正驗證了什麼。
閱讀文章
下一次看到 AI「解決了」一個問題,先找它交出的命題、測試或測量紀錄,再決定相信到哪一層。能被別人接手檢查的成果,才有機會變成下一段研究的起點。