
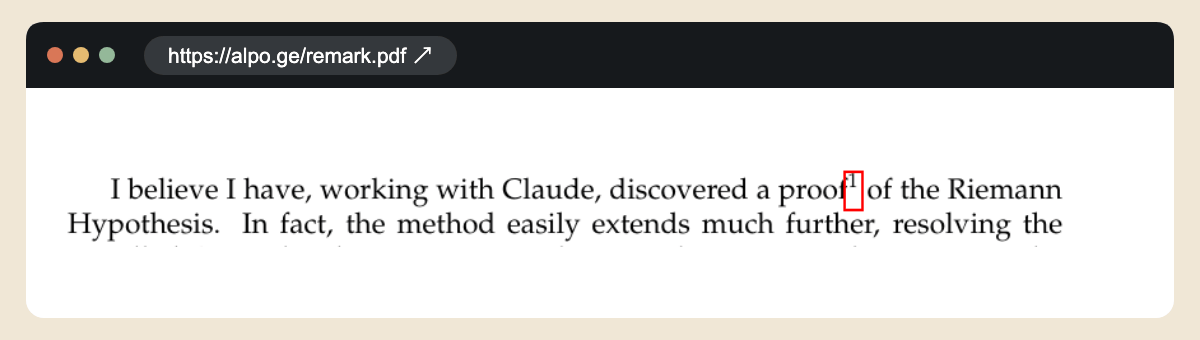
2026 年 11 月 20 日,數學家 Levent Alpöge 在個人網站公開了一份與 Claude 合作研究的原始公告 PDF,提出Claude 黎曼猜想證明的宣稱。一天後,Lean 與 Mathlib 社群發布聯合聲明,對證明正確性表達充分信心。故事已從作者宣布成果,走到社群公開說明驗證依據的階段。
值得追問的問題也變了:社群究竟驗了哪個命題?電腦接受證明,與人能解釋證明之間隔著什麼?這項成果又能支持多強的 AI 能力結論?先讀作者說法,再拆開驗證,最後判斷下一份值得看的證據。
一、作者交出的,是一份形式證明與一段尚待講清楚的研究故事
I believe I have, working with Claude, discovered a proof of the Riemann Hypothesis.
中文:我相信,透過與 Claude 合作,我已經發現了黎曼猜想的一個證明。
Levent Alpöge,原始公告第 1 頁
這句話的主詞是作者本人。公告描述的是人與 Claude 協作:作者提供方向、類比與研究判斷,也高度肯定 Claude 在後段推進的貢獻。這是當事人的研究回顧,能說明他如何理解這次合作;若要量化模型獨立完成了多少,還需要另有定義的任務與過程證據。
公告的數學線索,把函數域中的思路帶向整數問題,談到重數與反覆 theta 提升。可以把「重數」暫時想成讓某種約束重複發揮作用的強度,但這只是閱讀入口,不能代替論證。作者也坦言,自己對部分相關領域仍需加深理解,並打算整理出更容易傳授的寫法。
因此,作者同時交出兩種不同狀態的東西:可供機器檢查的形式化成果,以及他仍在消化、準備解說的數學圖景。期待簡化是他的判斷,不能預先當成已完成的簡短證明。
二、黎曼猜想在問什麼?先把「所有」與「抽樣」分開
Clay 數學研究所的問題介紹把重點放在質數分布偏離平均規律的幅度。其標準表述是:黎曼 ζ 函數的非平凡零點,實部都等於 1/2。這裡的「都」很關鍵;檢查再多個例子,與對全部情況給出推導,回答的是不同問題。
對一般讀者而言,可以把它想成:我們已能描述一條平均趨勢,現在要掌握實際起伏能偏到哪裡。這個比喻只幫助理解問題的角色,正式命題仍是關於函數零點。若形式證明有效,它提供的是一條覆蓋命題全域的邏輯鏈,而非把樣本量再往上加。
三、Claude 黎曼猜想證明:社群確認了哪四層?
Lean 與 Mathlib 社群的聯合聲明日期為 2026 年 11 月 21 日,並獲 Lean FRO 與 Mathlib Initiative 背書。聲明對這份黎曼猜想證明給出正面判斷,其依據可以拆成四道不同的問題。
We have full confidence that Alpöge’s proof of the Riemann Hypothesis is correct, and we congratulate him on this achievement.
中文:我們對 Alpöge 的黎曼猜想證明的正確性有充分信心,並祝賀他取得這項成就。
Lean 與 Mathlib 社群,2026 年 11 月 21 日
第一,題目本身寫對了嗎?聲明指出,使用的是 Mathlib 既有的黎曼猜想表述,並經熟悉 Lean 與數論的專家核對。這一步防的是「符號看起來相同,意思卻已變了」。
第二,程式庫實際編譯通過了嗎?社群報告有多人完成編譯,並重現相同的原始證明匯出檔。提交一包檔案,和別人能用它得到可檢查的產物,是不同層級的交付。
第三,證明的就是那道題嗎?社群另建只匯入 Mathlib 的題目檔,再用 Comparator 與 con-leche 的比較功能,核對提交成果與標準命題是否一致。可以把它想成先由驗收方保管題目,再比對答案究竟回答了哪個問題。
第四,推導能通過不同檢查器嗎?聲明說明,多套檢查器檢查了不會執行原始程式碼的證明匯出資料。這樣的交叉核對,讓可信度不只押在產生證明的模型或單次編譯上。
Claude 黎曼猜想證明值得重視,正是因為這些驗收問題被拆開回答。社群正面結論是重要的新證據;文章也應把結論明確歸給執行與彙整驗證的社群。
四、Claude 黎曼猜想證明的驗證紀錄:版本、時間與範圍一起讀
MIT 數學家 Andrew Sutherland 的公開驗證頁標示更新時間為 2026 年 11 月 21 日 12:55 UTC。該頁回報模組重播、獨立核心檢查與五項命題比對等結果,同時仍把部分流程列為執行中。它與稍後的社群整體聲明,提供的是不同時點、不同執行者的紀錄,不能混成「每個人、每個檢查都已跑完」。
同一頁也解釋某些隨版本附帶的舊檢查器,因不支援證明用到的型別結構而未能處理;較新的 con-leche 版本則接受了匯出證明。讀到非零退出碼,應先確認是數學推導被拒絕、工具能力限制,還是資源或版本問題。每種狀態需要不同的處置。
另一條界線是 GRH 的範圍。公開驗證所核對的推廣,是 Dirichlet L 函數的廣義黎曼猜想。Sutherland 明確把 Dedekind ζ 函數、Hecke L 函數及一般自守 L 函數排除在本次已核對命題之外。作者對更進一步推廣的期待,應繼續列為期待。
社群驗證儲存庫也提醒,共用編譯快取的完整性校驗,與證明驗證是兩件事。下載速度可以靠別人的快取改善;對數學成果的信任,仍要沿著題目、定義、依賴與檢查結果追查。
五、AlphaLab 的判讀:驗得過,與講得清楚,各有價值
我同意:這份成果的可信度,已超過作者單方面宣稱
一個模型寫出令人驚豔的推導,仍可能只是看起來像答案。這次公開資料的重要性,在於外部驗收方可以拿到具體產物,固定命題,再用不同檢查方式核對。聯合聲明給出的正面結論,應被認真對待;把它繼續描述成只有一段聊天回覆,會遺漏目前最關鍵的證據。
但多套檢查也有共享的基礎,例如數學定義與邏輯公理。Sutherland 的驗證頁清楚交代這層信任邊界。交叉驗證能削弱某一實作錯誤的影響,信心則來自整條可追查的鏈,並非來自「電腦」兩字本身。
我存疑:用一項成果,直接替模型的通用研究能力打分
證明的正確性,檢查的是交付物。模型的研究能力,還牽涉問題怎麼選、專家提供多少方向、嘗試多少次、用了多少資源,以及同樣流程換一題能否再成功。這些是不同的觀察對象。作者對 Claude 的讚賞值得忠實呈現,卻無法單靠讚賞推出某個可重複的成功率。
同理,程式碼長度描述形式化工程的體積,無法單獨衡量思想有多深、解法有多簡潔或工作有多少由模型完成。這次讀者真正得到的,是一項有公開驗收依據的重要成果;模型貢獻的細部分工,仍適合等待更完整的研究紀錄。
下一份高價值成果,是讓別人能借用其中的新思想
機器可檢查的長鏈,可以支撐「這個命題有推導」。可理解的數學說明,則幫助研究者知道哪些引理可抽出、哪個類比可移植、哪些假設值得放寬。兩種交付會互相補強:形式化讓簡化後的論證有可核對的對象,好的解說又讓人知道下一步該研究哪裡。
作者打算理解並傳授這份論證,正好點出成果的下一階段。後續最值得看的,會是關鍵結構的說明、較小的可重用引理,以及讓其他數學家能獨立使用的新方法。這比再累積一次社群熱度數字,更能顯示突破如何擴散。
六、現在怎麼讀這則新聞:保留三個問題
看結論時,問「誰在什麼日期驗了什麼?」把 11 月 20 日作者公告、11 月 21 日個別驗證紀錄、社群聯合聲明分開。分享 Claude 黎曼猜想證明的新聞時,附上聯合聲明,讓別人能直接看到正面判斷與它的理由。
看推廣時,問「是哪一類函數?」先守住 Dirichlet L 函數這條範圍,再談下一步;避免用一個 GRH 縮寫,替不同強度的命題一次簽收。
看 AI 能力時,問「哪份紀錄能支持這個歸因?」如果你在研究或工程中使用 AI,也可以借用同樣分工:先固定要交付的命題與驗收方式,再保存產物,最後把成果正確性與產生過程的貢獻分開評估。讓下一次成功,留下別人能接著使用的東西。
接著閱讀
左右滑動查看更多推薦