
2026 年 10 月 17 日,DeepSeek 在官方 API 文件的〈Change Log〉發布了 DeepSeek Flash-1017 更新,同日開放 Search/Fetch API。這則消息值得一起讀:前者聲稱讓模型以更短輸出完成更多工作,後者讓程式能直接搜尋與抓取網頁。真正影響選型的問題,是較高的評測分數,能否變成每份合格交付更低的成本。

先看官方究竟改了什麼,再把分數、單價與檢索費用拆開,最後判斷什麼工作值得拿來對照。這裡的榜單數字均按發布者歸屬呈現;本文沒有執行模型性能測試。
DeepSeek Flash-1017 更新:模型入口沿用,服務版本前進
The API calling method and pricing remain unchanged
中文:API 的呼叫方式與價格維持不變。
DeepSeek,2026 年 10 月 17 日更新紀錄
官方說明網站、App 與 API 已切到新版本,API 繼續使用 deepseek-flash。目前的定價表也將這個名稱對應到 DeepSeek-V4.1-Flash-1017。對使用者,更新容易抵達;對想比較前後差異的人,同一個 API 名稱則不足以證明兩次測試用了同一版本。請把執行日期與當時服務版本一起記下。
DeepSeek 在1017 模型卡將它定位為既有 Flash 的小幅版本更新,並公布權重與 MIT 授權。這有助於研究者保留指定材料,但開放權重與託管 API 是兩種交付方式;要比較性能,仍要對齊推論設定、工具與執行環境。
DeepSeek Flash-1017 評測:31.2 到 42.3,先保留版本與框架
以下節錄同一份官方模型卡的新舊版本對照。它們是 DeepSeek 自報的測試結果,不是 AlphaLab 或其他機構替它重跑的成績。
| 官方指標 | 原 V4.1 Flash | Flash-1017 | 分數差 |
|---|---|---|---|
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 |
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 |
| ProgramBench | 20.3 | 29.1 | +8.8 |
| NL2Repo-Bench | 65.4 | 68.2 | +2.8 |
31.2 到 42.3 的差為 11.1;以舊值為分母,相對增幅約 35.6%。「多 11.1 個百分點」與「相對增加約 35.6%」是兩種尺度,更不能把後者改寫成「開發者生產力提高 35.6%」。你完成的任務、可用工具和驗收方法,才決定能承接多少改善。
模型卡註明,Terminal-Bench 4.0 使用 Claude Code 框架,DeepSWE v1.1 使用 Mini-SWE-V2。這是測試組合的一部分。Terminal-Bench 維護者的執行指南則顯示,4.0 經 Harbor 執行,包含需要 GPU 環境的任務;官方榜單也把模型和 Agent 分欄列出。這些獨立的一手文件支持「框架與環境需要一併看」的解讀,並不替 DeepSeek 的 42.3 背書。
因此,本文保留同版基準內的新舊對照,不把不同 Terminal-Bench 版本的分數連成一條進步曲線。若你想先釐清模型與執行框架的分工,可以接著讀AI Agent Harness 是什麼。
官方的成本圖,想證明什麼?
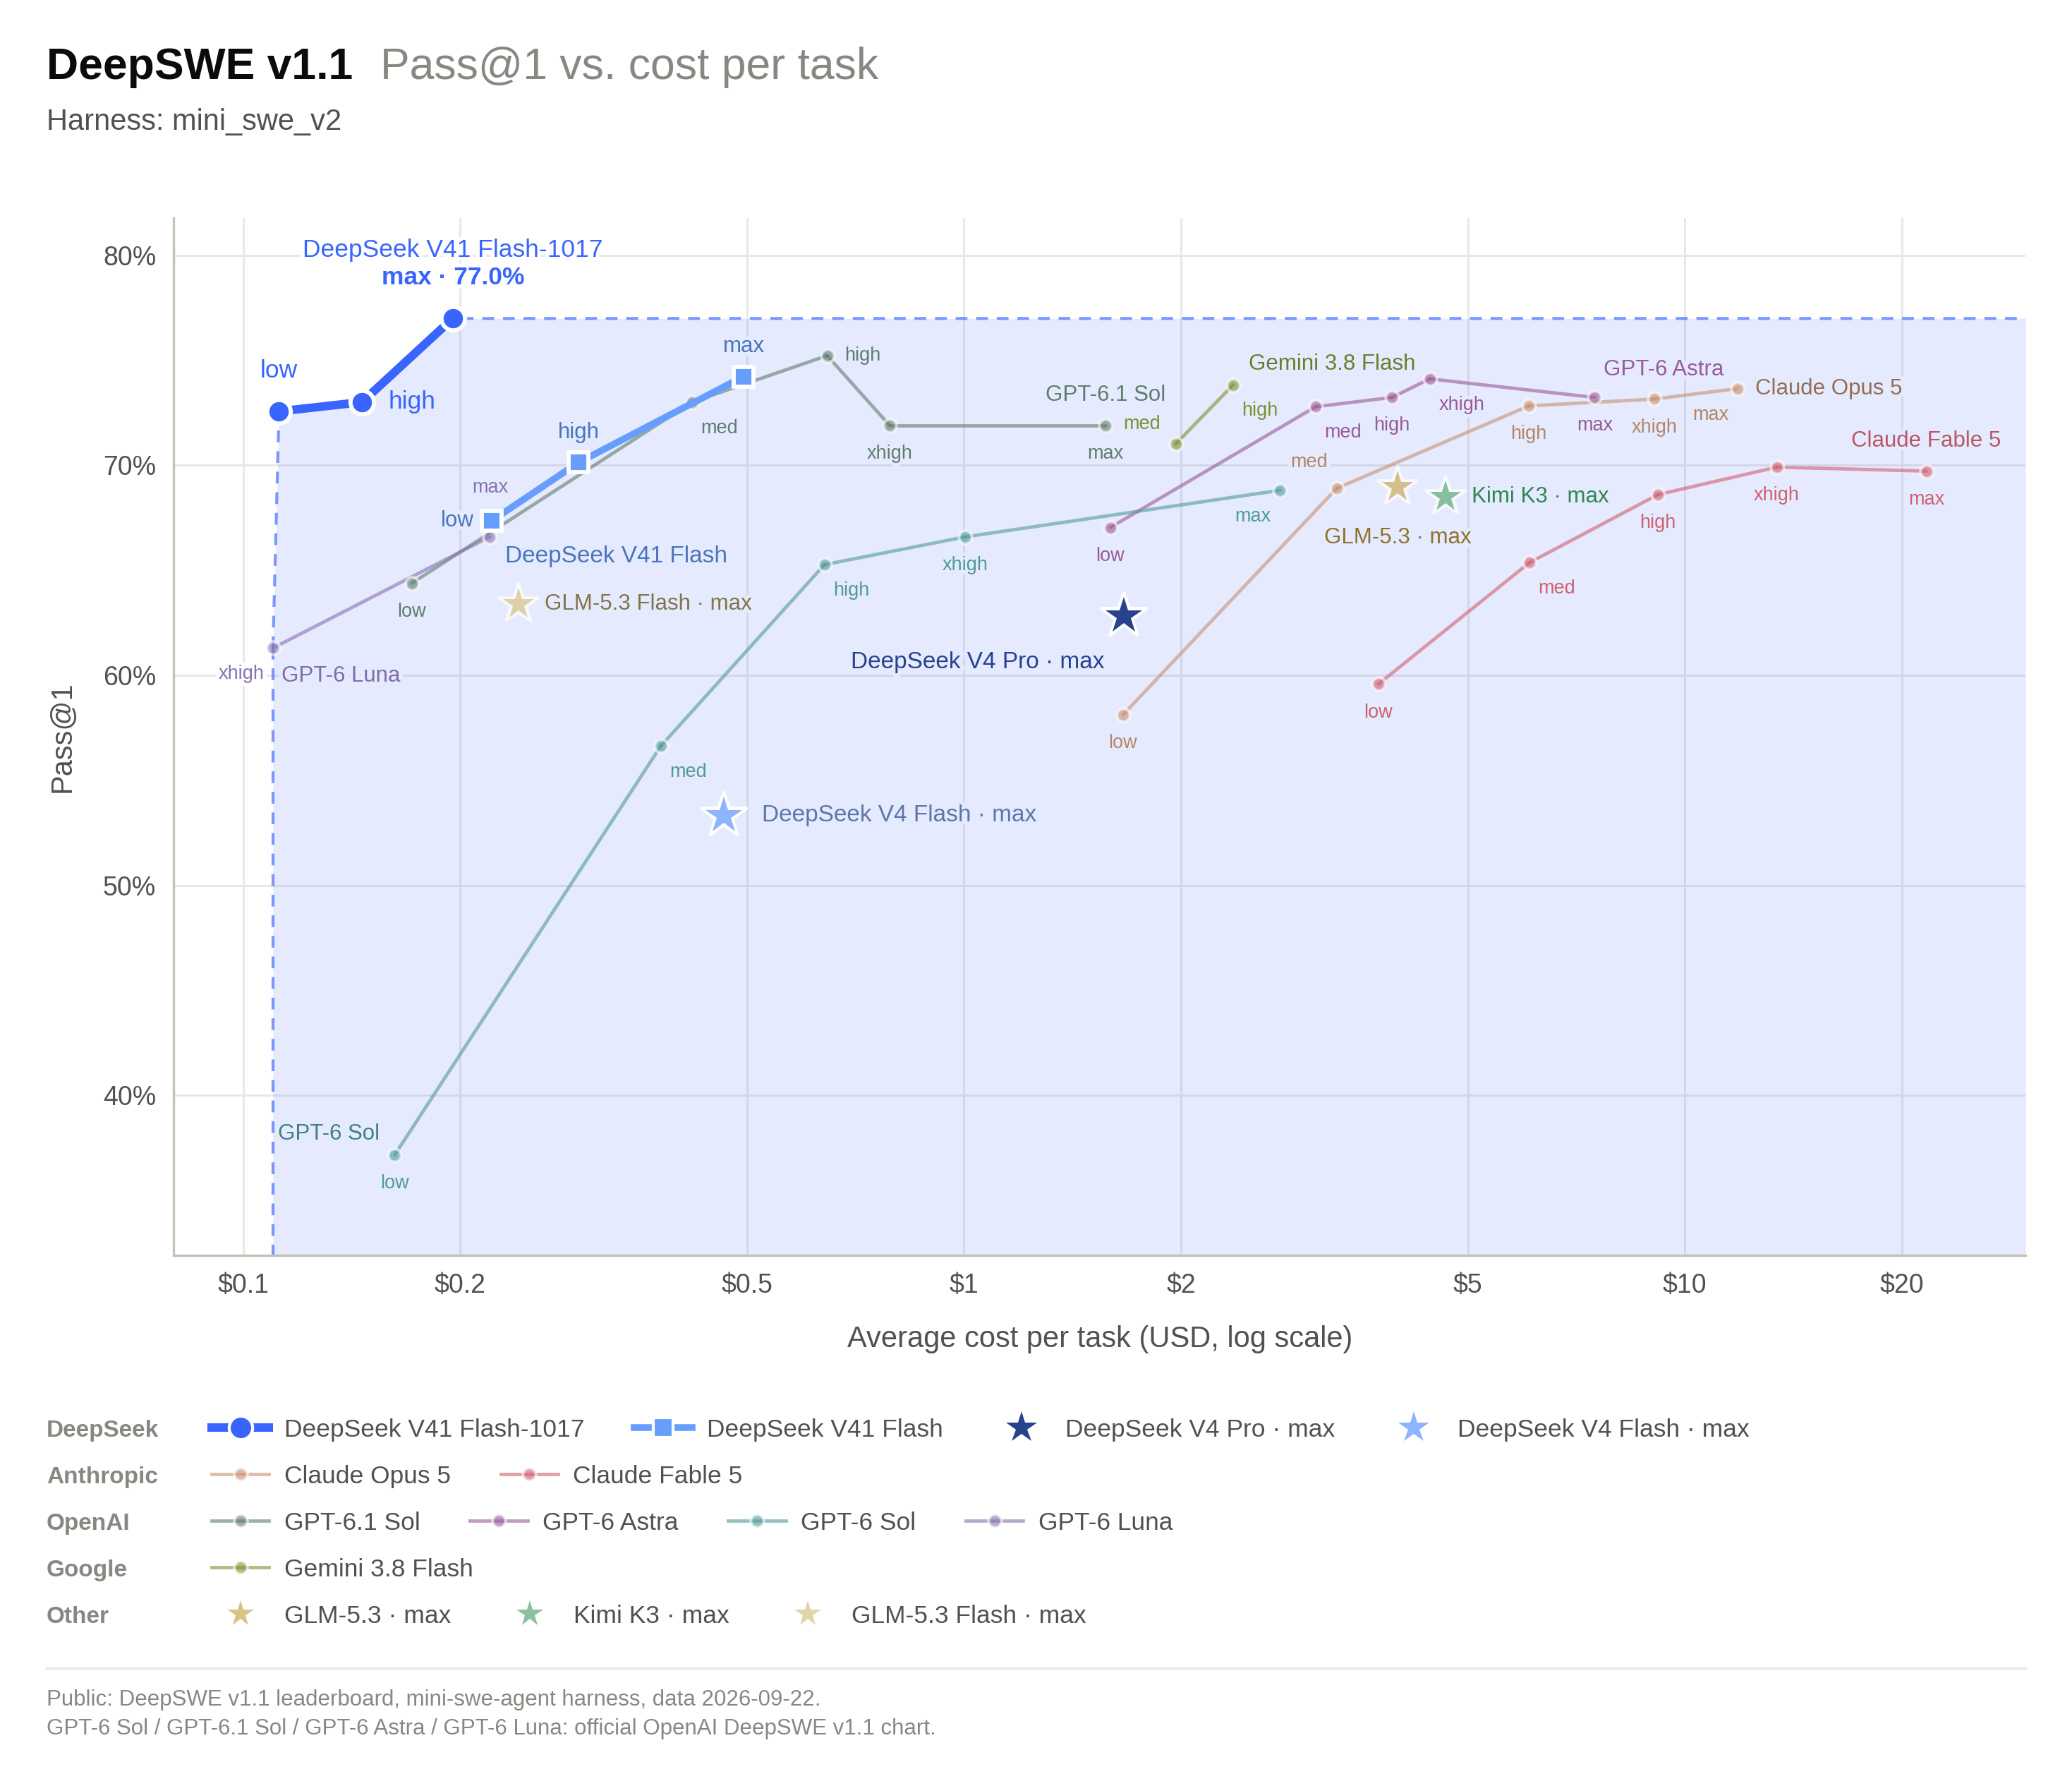
這張發布頁中的圖把新 Flash 放在更靠左、也更靠上的區域:在圖示測試條件下,希望用較低花費換較高的首輪解題表現。橫軸是對數刻度,不能把相同的像素距離當成相同美元差。不同推理檔位也各自是一個點,而不是模型名稱背後永遠固定的價格與能力。
官方還展示遊戲與 3D 場景,並把完整專案開發的改善歸因於帶有自我回饋的強化學習。這些示範說明它想推進的工作型態:從回答一段話,移到完成一個可運作成果。示範很有吸引力,選型時則要另外問:一共試了幾次、失敗花多少、交付後有哪些測試通過?展示片段本身回答的是「這個例子做出了什麼」。
搜尋 API 開放:取到網頁,還要判斷證據
Search & Fetch APIs are now open to everyone!
中文:Search 與 Fetch API 現在向所有人開放。
DeepSeek,2026 年 10 月 17 日發布頁
依官方 Search/Fetch 指南,Search 依查詢回傳結構化搜尋結果,Fetch 取得單一網頁並回傳 Markdown;兩者沿用 DeepSeek API 金鑰驗證。這裡的「開放」指公開提供 API 存取,不是匿名、無限或永久免費使用。
這項改變的價值,在於開發者可以把「找資料」與「讀原頁」接進自己的流程。Search 回來的摘要適合篩選線索;Fetch 取得的內容則讓你回到原頁檢查日期、適用條件與上下文。兩個步驟都值得保留 URL,而不是只留最後生成的結論。
更新紀錄也自述搜尋引擎有大型索引,並會過濾 SEO 垃圾、GEO 操弄與低品質 AI 內容。這是供應商對系統的描述。檢索排名靠前、原頁可開啟、引用真正支持答案,是三個分開的驗收問題;用你熟悉、知道正解的題目,才能判斷這個新資料入口是否適合你的工作。
Search/Fetch 費用,要與模型 token 分開算
截至 2026 年 10 月 18 日,官方指南與定價頁列出:Search、Fetch 各為每 1,000 次成功請求 US$0.75。計費還要求 Search 回傳非空結果、Fetch 取得頁面內容;失敗、搜尋空結果與逾時不計費。回傳幾筆搜尋結果不改變每次請求的單價。
指南另列特定過渡安排:使用 DeepSeek API,經 DeepSeek Harness、Claude Code 或 Codex 呼叫的伺服器端工具,目前暫免這筆請求費,預定在 2026 年 10 月 31 日 16:00 UTC開始計費,也就是 11 月 1 日 00:00(UTC+8)。這個範圍與期限,不能擴寫成所有直接 API 請求都免費;模型 token 用量也要另外看。
做一個按標準費率計算的假設:某份研究用了 2 次計費 Search,再對 5 個網頁各做一次計費 Fetch,檢索費合計為 (2+5) × 0.75 ÷ 1,000=US$0.00525。這只是七次成功請求的算式,尚未加上模型 token、執行環境或人的驗收時間;它不是本文實測帳單。
一次請求看起來便宜,重複搜尋、抓取無關頁面與整題重跑卻會累加。相反地,如果更好的搜尋減少錯誤線索與返工,它也可能降低總成本。應該比較的是同一份合格成果的完整花費。
AlphaLab 的判讀:值得試,但要把「更省」落在交付上
一、我同意:少繞路,比只壓低單價更有價值
在單價不變時,若模型能用較少輸出和較少嘗試完成同樣工作,使用者確實可能省錢。這是 Flash-1017 最值得驗證的主張。重點是「同樣工作、相同品質」:把本來需要的解釋或檢查一起刪掉,帳面下降並沒有回答這個問題。Thinking Inertia 教學也說明,短答案、用量與答對要分開量。
二、我存疑:成本優勢能否跨過你的工作邊界?
官方圖的比較範圍是一組基準、框架與設定;你的程式庫可能更依賴舊文件、私有工具或跨頁查證。要相信優勢可以轉移,最有說服力的材料會是固定任務下的完整紀錄,包含成功、失敗與重試,而不是只挑最便宜的一次。AgentSWE 評測解析提供另一個角度:示範過關,與未見任務能否交付,需要各自的證據。
三、搜尋與模型要分開換,才能找到改善的來源
這次同時更新模型與資料入口,很容易把全部好處記在模型身上。比較時可以先固定資料、工具與驗收題,只更換可明確辨識的模型版本;再固定模型,觀察新檢索入口帶來的差別。如果你已無法取得原服務版本,就記下這個比較限制,不要把兩次不同日期、不同設定的體感當成嚴格對照。
四、值得追蹤的是每份合格交付的成本
把整組測試的模型費、檢索費與執行費加起來,除以合格交付數;零份合格時,就保留全部花費並記為尚未交付。另記人工修正時間,不急著把它換成任意時薪混進模型費。這樣你會看到:新版本究竟省下 token,省下返工,還是只把成本轉移到另一層。
下一步:用一份熟悉的工作,核對更高分的價值
一般使用者可以挑一份自己能判斷好壞的文件或小型程式任務,先寫下交付條件,再保留完整輸出與等待時間。已經使用 API 的開發者,則把版本、Harness、推理設定、成功請求數、token 與失敗原因一起記錄;這是一份建議驗收方法,不是本文已完成的測試。
先準備幾個容易誤判的情境:舊版與新版文件並存、搜尋摘要漏掉限制、原頁抓不到、程式能跑但結果不對。方法可以參考AI Evals 入門。Flash-1017 值得進入候選,因為它提出了一個明確可問的改善:同樣的錢,能否更快拿到更多合格成果?讓自己的任務回答,再決定擴大使用範圍。


