
2026 年 11 月 12 日,Edge0 在官方部落格發布了〈Introducing Edge0-145B: Frontier AI Capabilities on Your Own Computer〉,宣布 Edge0-145B 與 Edge0-120B,主張把大型 Agent 的程式、推理與工具工作搬到個人電腦。官方 GitHub 將這次模型發布記為 11 月 13 日;兩個頁面的日期分別保留,別把它們當成兩次推出。
這次值得關注的是可下載模型與推論引擎的組合;決定你能否採用的,則是模型血統、記憶體搬運、平台發布狀態與授權。先看原文想完成什麼,再對照實際發布資產,最後把「跑得動」接到「能交付什麼」。本文依 2026 年 11 月 14 日可讀取的官方頁面整理,未在本機執行 NVIDIA 推論。
一、Edge0-145B 的主張:讓大型 Agent 長時間留在電腦裡
原文的核心很有吸引力:如果程式助手要來回規劃、寫碼、執行、看畫面再修正,每一回合都上雲,就同時牽涉費用、連線與資料處理。把模型放在自己的電腦,可以替這些反覆工作增加一個可控制的選項。
Edge0 用四層設計解釋它的路線:讓專家共享部分投影矩陣、配合低位元訓練、把 GPU/RAM/SSD 的讀取與計算重疊,以及共同調度 CPU、GPU 和推測解碼。這不是把每個參數永遠塞進顯卡的故事,而是讓每一步少算、少搬,並把等待藏進其他計算。
展示涵蓋 Blender 城市場景、影片、遊戲、無人機程式與 PCB 設計。它們傳達的精神,是把模型變成能串起多個工具的工作者。不過,成品展示只能讓我們看見被選出的流程;若要判斷成功率與成本,還要知道失敗任務、重試、人工介入和外部工具各用了多少。原文對人工製作工期與成本的比較,本篇不當作已驗證的節省額。
原文也承認硬體仍有限制,需要即時資訊或跨裝置服務時仍可能連網。真正有用的主張,是讓更多工作可以選擇本機執行,而不是把「離線」擴張成整套工作永遠不接觸網路。
二、Edge0-145B 從哪裡來:Qwen 基底與 Strata 引擎要一起看
Hugging Face 模型卡標出基底為 Qwen/Qwen3.8-Flash-Next;官方模型文件也直接寫明,edge0-strata 是 Niko1221 與社群所建 Strata 的分支,加入 latent MoE 支援。這兩項來源是理解新發布的起點。
原文把訓練描述成從端側架構出發,並強調不只是事後壓縮雲端模型。這個說法需要和已揭露的 Qwen 衍生關係一起讀:它可以描述對架構與訓練流程的修改,卻不足以證明這是完全從零建立的新基礎模型。反過來,知道基底也不足以把所有修改都說成單純換包裝。要判定新增價值,應比較相同任務下的品質、搬運量與完成時間。
這條路有更早的研究背景。Qwen 團隊的架構論文已把稀疏專家、混合注意力與額外 n-gram 表放進同一套設計。Edge0 的 9 月論文研究的則是 35B 模型與 SSD 路由預測;它可以解釋團隊如何思考記憶體牆,卻不能直接作為新 145B 模型效能的獨立驗證。
MoE 可以想成有許多專門工位的工廠:每一步只挑部分工位運算,未上場的工具仍要存放。latent MoE 再把送入專家的訊號壓到較窄的維度,以減少專家部分的成本。總參數、每步參與運算的參數、檔案大小與執行時記憶體,是四份不同的帳。
三、每秒 121.2 Token 與 29GB:先把測量條件攤開
公告把 29GB 峰值記憶體與每秒 80 以上 Token 放在筆電敘事裡。對照 目前模型測速表,可以讀到更具體、也更適合核對的版本:以下全部是 Edge0 自行回報的 Edge0-145B Q3_K 結果,不是 AlphaLab 實測。
| 官方測量條件 | Chat decode(tok/s) | Agent decode(tok/s) |
|---|---|---|
| RTX 5090 D 24 GB,Q3_K | 99.7 | 121.2 |
| RTX 4090 24 GB,Q3_K | 69.9 | 91.7 |
| 同一張 RTX 5090 D,限制 16 GiB VRAM+20 GiB 系統 RAM | 36.8 | 44.9 |
第三列不是另一張 16GB 顯卡的測試。官方說明使用同一張 RTX 5090 D,透過顯存預留與 cgroup 限制記憶體,且關閉 swap。這種控制能研究容量壓力,仍保留原卡的運算與頻寬特性,不能直接拿來保證另一台較小顯卡的速度。

同一份文件還列出:開啟 residency 的另一組讀值,145B Q3_K 權重為 40.81 GiB,顯存占用 23.14 GiB、主機 RAM 占用 31.28 GiB。這些讀值與前述受限測試屬於不同條件,不應相加後冒充同一場測試的最低需求,也不應拿公告的 29GB 直接取代它們。
同樣地,GPU 裡的專家快取、主機 RAM 裡的另一批專家、SSD 上按需讀取的表與權重,會把容量壓力分到不同位置。每步只啟用少量專家,降低的是部分運算;資料放在哪、多久搬一次,仍決定實際延遲。讀檔案大小也不能推算長對話的總占用。
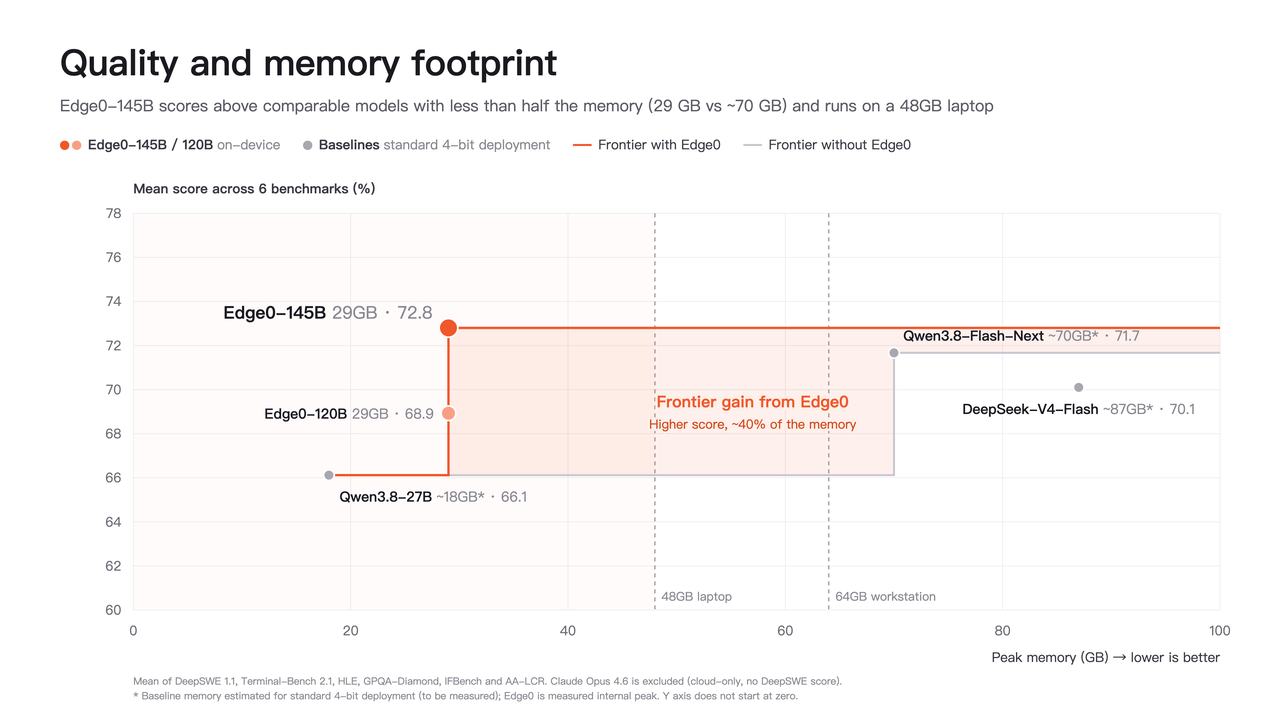
上圖的比較還多一個口徑差異:原文將自家測得的峰值,對比其他模型標準 4-bit 部署的估計值。這能提出值得測試的方向,卻無法單憑圖上距離,斷言同一台機器完成同一項工作一定省下多少 RAM。圖的縱軸也沒有從零開始,視覺差距與實際分數差要分別看。
四、平台支援的落差:有 Apple 測速,不等於 Mac 已能照發布流程跑
For Edge0-145B, day-one support covers macOS, Windows, and Linux
中文:對 Edge0-145B 而言,首日支援涵蓋 macOS、Windows 與 Linux。
Edge0 原始公告節錄
這是原文的明確承諾。但截至 11 月 14 日,repository 的平台表對新 145B/120B 列出的發布組合,是 Linux 或 Windows、NVIDIA GPU 與 CUDA 13;35B 的原生引擎則另列 macOS、iOS 與 Android 路徑。不能把舊模型的平台清單套到新模型。
They do not establish macOS release availability.
中文:它們不能證明 macOS 版本已可取得。
Edge0 模型文件對 Apple M2 Ultra 測量的註解
官方測速表確實保留 Apple M2 Ultra 的 Metal 結果,但模型文件緊接著給了上面這句限制。因此,本文不把公告的「首日 macOS」當作已被發布資產證實的事實,也不推成「Mac 永遠不能跑」。Mac 使用者現在應等待新模型專屬的可取得資產、建置與啟動文件彼此對齊,再決定投入下載與設定時間。
五、前沿能力與開放權重,分別承諾了什麼?
Edge0-145B 在官方內部評測表的 DeepSWE 1.1 為 64.6、Terminal-Bench 2.1 為 86.5。這些分數是作者回報的研究線索,還不足以證明它在你的專案與提示下勝過所有雲端模型。更快輸出、較高解題分數、較高工具任務完成率,應分別驗收。
發布文件本身也有版本落差:公告的 120B 表格列出 DeepSWE 53.6、Terminal-Bench 81.3;本次查閱的 repository 則是 51.3、75.3。文章保留這個差異,不挑較高的一組替它背書。官方並說品質分數按模型列出,未分開提供 Q3_K 與 NVFP4 的品質評估;因此不能把某一格式的速度和另一份未分格式的分數拼成同一場完整測試。
r/LocalLLM 的使用者 LightBrightLeftRight已貼出 RTX 3090、32K 測試的個別測速回報;那是該使用者的單機觀察,不能直接搬到另一組硬體與格式。本次查閱尚未找到足以獨立確認上述新模型標題效能的完整公開實測。這不表示模型無效,而是目前可採用的結論應停在「官方提供了可檢查的模型、引擎與自報結果」。若要提升為可靠替代方案,下一份更有價值的證據會是固定版本、同一套工具與題目、完整失敗紀錄的可重跑比較。
授權也要分開看。Edge0 Community Model License 1.0針對其明確指定、且有權授權的 Edge0 貢獻;框架與 Strata 的程式碼保有各自授權。模型條款列出個人、研究、組織內部使用與生成輸出商用等許可,同時保留模型銷售、商業模型服務及特定獨立商業 Coding/辦公助手的另行書面授權要求與例外。適用的 Qwen 上游條款也要同時滿足。
因此,準備把它包成收費服務的人,應先核對 release scope與實際下載版本,而不是把 repository 的 Apache-2.0 標籤當成所有權重的商用通行證。這裡的實務重點,是先確認你的產品形態落在哪一段條款。
六、AlphaLab 的判讀:值得測的是可交付工作,而非大參數標籤
我同意:模型與搬運路徑一起改,能打開更多本機選項
把結構、量化、路由與執行器一起設計,是這次最值得追蹤的方向。當任務要反覆讀檔、跑工具、修正輸出,本機模型可能讓資料控制與使用量成本更容易規劃。Qwen 基底與 Strata 上游不會自動抹去改進價值;改進應由同條件下的結果來說明。
我存疑:把單項展示延伸成普遍替代,跨了太多條件
參數多不直接等於更會做事;一秒吐出更多 Token,也不直接等於更快交件。若需要更多重試、工具格式常錯,或每輪都重新讀長歷史,漂亮的 decode 數字仍可能被等待吃掉。成品展示能啟發用途,採用決策則要回到自己的失敗成本。
平台與版本對齊,也是產品能力的一部分
一個模型的實用邊界,包含別人能不能取得同一版本、照文件啟動、理解記憶體預算並重現行為。公告、模型卡與 repository 若用不同口徑,讀者要付出額外核對成本。把這些文件對齊,會比再多一個漂亮的總分更快增加可信度。
下一步:已有合適硬體的人,先驗一件能對帳的工作
先固定模型格式與 commit、引擎、顯卡、RAM、SSD 和 Context,再選一個答案可核對的小任務。記錄載入時間、首段輸出等待、完整正確交件時間、工具錯誤與人工介入次數;把冷啟動和續聊分開。以相同設定比較你原本的方案,才知道本機化換到了什麼。
首次測試用複本程式庫與假資料,限制可寫資料夾,先讓工具提出修改再核對執行結果。模型留在本機,不會自動讓外部搜尋、工具連線或程式執行變得可控;要檢查的是整條工作流。沒有相容發布路徑的人,先完成版本與硬體核對表就很有價值。
若你正在處理具體卡頓,可接著看 RAM/NVMe 等待診斷與 GPU 用量與模型歸因。這篇的採用判準是:拿同一件工作,換到可核對的品質、可接受的等待與可掌握的資料路徑,再擴大使用。
接著閱讀
左右滑動查看更多推薦
 內容類型:文章
LFM2.5-24B-A2B 發表:2B 活躍參數背後,速度、容量與隱私怎麼讀?(2026)
Liquid AI 把更大的 MoE 帶進本機代理。核對 2.45B 活躍參數、184 tok/s 的測試條件與完整檔案容量,再分開看工具能力、資料流及合格交付。
閱讀文章 內容類型:文章
Flint 本機編碼模型解析:每秒 125 tokens,工作也會更快嗎?(2026)
Recursive 公開 Flint 權重與本機推論引擎。從 40B/2.5B、Mac 硬體要求到外部原始速度紀錄,拆開廠商編碼分數與自我改進敘事,判斷它適合承接哪一類工作。
閱讀文章 內容類型:文章
K2 Horizon 深度解讀:六模型已開,完整訓練堆疊到齊了嗎?(2026)
K2 Horizon 一次公開六個尺寸,但 32B 仍是 Stage1,完整訓練程式碼與 logs 尚未到齊。本文查核 MoVA、Uno、benchmark 與 reward hacking,判斷這是完整開放,還是尚待履約的路線圖。
閱讀文章 內容類型:文章
【2026 最新】Reladraw 教學:AI 架構圖如何反覆修改並輸出 SVG(安裝+驗收)
用 Reladraw 0.9.0 把文字關係寫成架構圖:從五節點範例開始,讓人與 Agent 修改同一份來源檔,輸出 SVG 並依程式碼驗收。
閱讀文章 內容類型:文章
【2026 最新】Compile by Training 是什麼?把自然語言規格編譯成本機神經函式
從自然語言規格、Teacher 合成與 LoRA 訓練,到四組 holdout、OOD、spec drift、損益平衡與隱私邊界,一篇學會如何評估、版本化並安全整合 Compile by Training 神經函式。
閱讀文章 內容類型:文章
【2026 最新】哪些決策不該交給 LLM?Deterministic Core 6 步實作(決策矩陣+故障注入)
LLM 擅長理解模糊意圖,卻不該裁決價格、政策或不可逆動作。本篇用一筆訂單示範 Deterministic Core × Probabilistic Edge:從決策矩陣、typed schema、pure function 到故障注入與 fail-closed,做出可驗證的 AI 管線。
閱讀文章