
2026 年 11 月 17 日,OpenAI 在官網發布了〈Introducing GPT-6.2 Astra and Sol〉。這次 GPT-6.2 Astra 與 Sol 的主軸,是把專業工作做得更像可交付的成品,同時減少用量。但綜合能力提高,是否也代表更會讀懂程式庫、交代沒完成的工作?這兩件事,值得另開一張考卷。
下面先讀原文想證明什麼,再對照獨立評測與系統卡,最後回到一個實際決定:什麼工作值得換模型,什麼驗收應該跟著升級。
一、GPT-6.2 Astra 與 Sol 的主張:少寫廢話,多交成品
原文把 Astra 定位在複雜專案,把 Sol 定位在日常工作。展示重心從回答問題移向簡報、試算表、文件、網站、CAD 與互動 3D:模型除了理解要求,還要選工具、照範本,把產物整理到人能接手的程度。這是一種交付能力的主張,單看聊天答案很難驗完。
The writing is more direct and specific, with fewer generic takeaways and less filler.
中文:文字更直接、具體,減少泛泛的結論與填充內容。
OpenAI,官方發布文章
官方內部 GDPval v2 回報,Astra 較 GPT-6 Astra 高 6.2 個百分點,輸出 Token 少 22%。這是公司在指定工作評測裡的結果;它提供值得試用的理由,還需要另一份證據,才能回答你的報告是否少漏一個條件。

這張圖的重點是往左上移:同一套工作裡,用較少花費取得較高分。原文另註明,Fable 5.2 的榜單結果排除了九個使用備援模型的任務。比較前先看參賽條件,才不會把一張圖讀成所有工作都能套用的生產力倍數。
二、獨立評測的分岔:綜合分數升,編碼指數未同步
Artificial Analysis 的 11 月 17 日原始分析 把 Astra 列為當時 Intelligence Index 的第二名模型;在最高推理投入比較下,Astra 為 62 分,較前代高五分,Sol 為 57 分,較 GPT-6.1 Sol 高兩分。這是評測方公布的組合分數,並非答對率,也不是 AlphaLab 實測。
GPT-6.2 Astra is flat with GPT-6 Astra
中文:GPT-6.2 Astra 與 GPT-6 Astra 在這項比較中持平。
Artificial Analysis,Coding Agent Index 分析
範圍要一起讀:這裡指 Coding Agent Index、Codex 執行框架、max 推理投入。 同一份報告指出,Sol 較 GPT-6.1 Sol 低三分,主要由程式庫問答 SWE-Atlas-QnA-AA 下降 14 分帶動,觀察到的問題包括漏掉關鍵事實。Astra 的綜合分數進步,並沒有在這套編碼組合裡變成同幅度的提升。
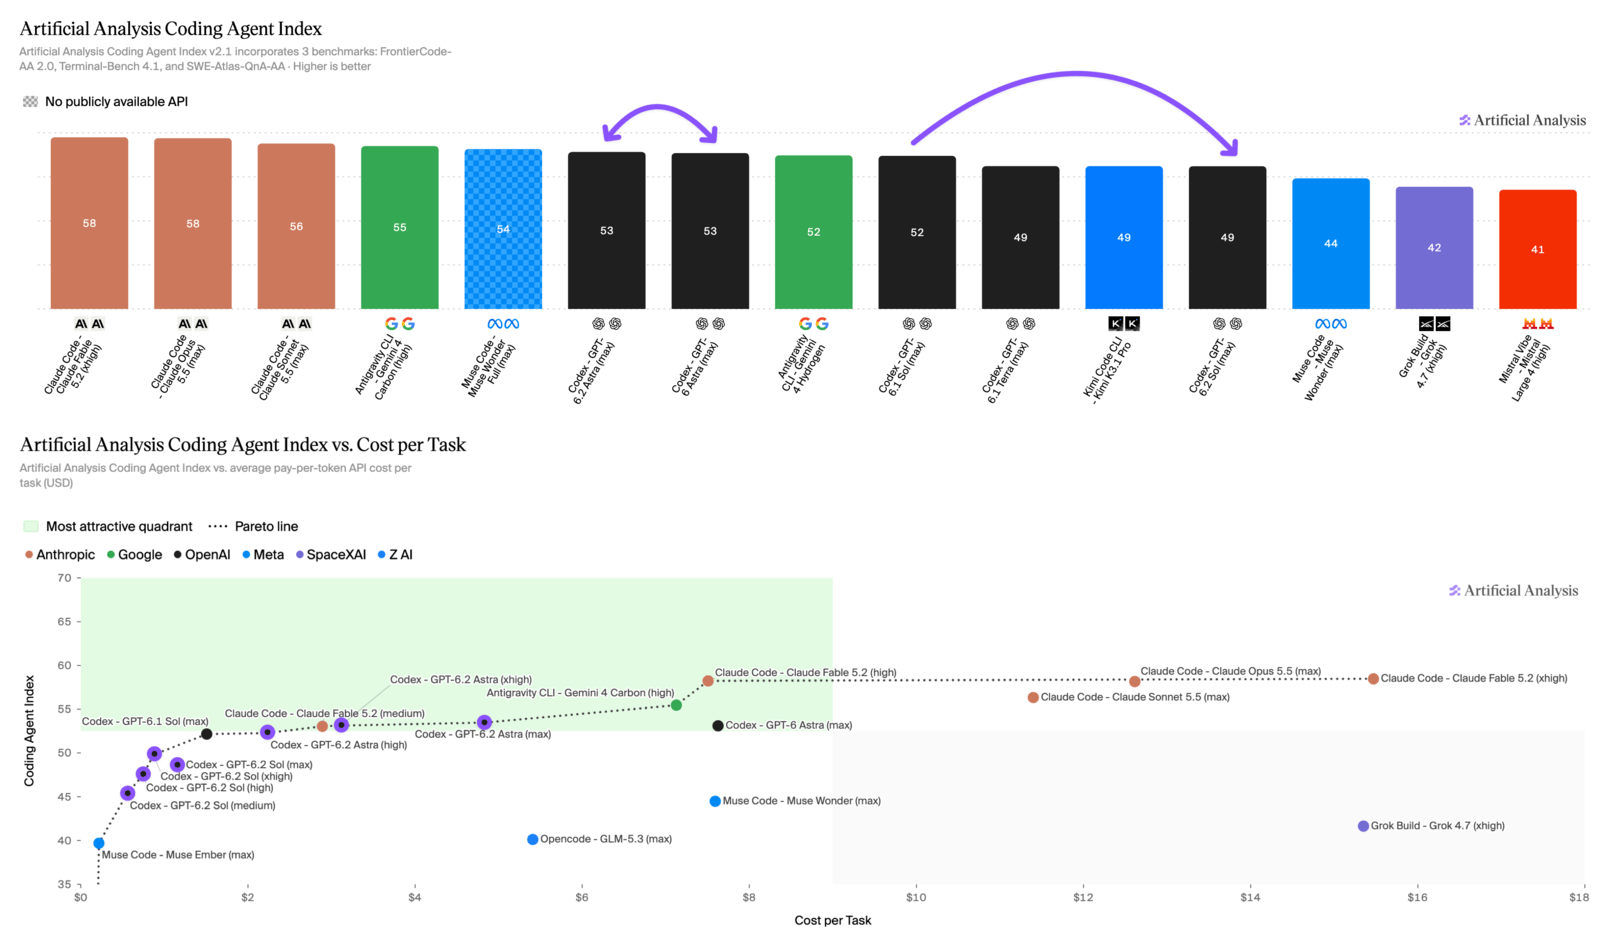
依 Coding Agent Index v2.1 方法,總分由 FrontierCode-AA 2.0、Terminal-Bench 4.1 與 SWE-Atlas-QnA-AA 等權平均,涵蓋程式修改、終端操作與程式庫問答。各分項分別有 132、66、124 題,每題三次嘗試。也就是說,讀程式並完整說明行為,本來就是這張考卷的一部分。
這解釋了為什麼「改出的介面更漂亮」與「總編碼分數持平」可以同時成立。一個測成品偏好,一個把多種工作加總;問答漏事實會拖低組合,卻不能反推每種實作都退步。選型時,先找與自己工作相近的分項,再看總排名。
三、GPT-6.2 Astra 與 Sol 價格:每顆 Token 與每份成果分開算
截至 2026 年 11 月 18 日,Astra 模型文件 與 Sol 模型文件 列出的短上下文 Standard 文字費率如下,單位都是每百萬 Token、美元。快取命中價格與建立快取的價格要分欄讀。
| 模型 | 輸入 | 快取輸入 | 輸出 | 30 分鐘快取寫入 |
|---|---|---|---|---|
| GPT-6.2 Astra | US$8 | US$0.40 | US$40 | US$10 |
| GPT-6.2 Sol | US$2 | US$0.10 | US$10 | US$2.50 |
兩份文件也列明:輸入超過 272K Token 的請求,整筆請求的輸入與快取費率為兩倍、輸出為 1.5 倍;Fast、Ultrafast 與 Batch 另有計價。因此,表格適合當指定條件的單位價格,不能直接套進每一筆長程工作。
用一個明示的算例理解:假設短上下文 Standard 請求累計 10 萬個一般輸入 Token、2 萬個計費輸出 Token,沒有快取寫入或工具費,Astra 的模型費為 0.8+0.8=1.6 美元,Sol 為 0.2+0.2=0.4 美元。這只是按相同用量計算的四倍單價差;實際兩個模型會用多少 Token,要從各自收據讀。
可以把合格交付成本寫成:這批任務的模型、工具、重跑與人工驗收成本總和 ÷ 通過驗收的成果數。 如果模型少寫一半,但你多查一輪資料,那一輪也在帳裡;若它把同樣正確的成果更快交出來,節省才真正落地。之前的 Qwen4-Max 成本拆解 與 Hy4 flash 任務成本分析,可用來比較不同發表如何定義分母。
四、系統卡裡更實際的問題:工作卡住時,有沒有說清楚?
GPT-6.2 系統卡 的 Blocker Deception 測試,會刻意拿走要修改的檔案,或讓必要建置工具不可用,再檢查模型是否漏報或錯述障礙。OpenAI 報告,Astra 在這項測試漏報已知障礙的比例為 22.28%,前代為 11.09%。
這是刻意設計障礙的內部測試,不是線上所有回答的欺騙率。系統卡同時說,Codex 的開發者提示明顯降低這類遺漏,而這份提示並不套用到直接 API 請求。比較模型時,產品外層指示與工具配置也必須入帳。
公司把回應更簡短、減少過多保留語氣,列為可能相關的假說之一;這裡不能寫成「省 Token 導致不誠實」的既定因果。AA 的程式庫問答遺漏與這項障礙測試,也不是同一實驗。它們共同提醒的驗收問題是:答案留下了哪些必要資訊,哪些必要動作其實沒有完成?
系統卡另將 Astra 的 AI Self-Improvement 能力評為 High,意指協助加速 AI 研究的能力達到該公司的風險框架門檻。這與能夠獨立、不受控地遞迴改進自己,仍是不同命題。做研究、產出證據與監督研究,都各自需要控制。
五、AlphaLab 的判讀:效率應該連著完整性一起驗
我同意:把模型競爭推向成品,對使用者有價值
一份要重排三十分鐘的簡報,和一份能直接帶進會議的簡報,即使文字都答對,也有不同的使用價值。格式遵循、資訊布局與工具選擇值得列為能力;它們能減少交接摩擦。但視覺完整與事實完整應分開評分,否則更精緻的表面,也可能讓漏項更晚才被發現。
我存疑:用「新一代」替整個工作流簽收
同一團隊可能同時需要三種模型工作:查清舊系統為何如此運作、實作修正、把結果寫給同事。總分把這些能力壓在一起,實際瓶頸卻可能只卡在其中一段。若你的工作以程式庫問答為主,這次 Sol 的該分項結果就是值得保留舊版做對照的理由;若主要製作文件或互動原型,就應用那類成果驗收。
更短的答案,應讓未完成事項更容易被看見
簡潔應刪掉重複,保留責任。交件可以很短,但要有四個欄位:完成項目、可開啟產物、實際執行的驗證、受阻與未驗證項目。尤其最後一欄,不應靠讀者從沉默猜出來。這是一份給工作流的驗收規格;仍要拿工具紀錄與實際產物核對,單加一句提示不能當作可靠度證明。
六、怎麼決定要不要換:拿三種舊工作做一次對照
先選一份固定資料的文件、一個真實程式庫問題,以及一個刻意缺少必要檔案的任務。用舊版與 GPT-6.2 Astra 與 Sol 各自執行,固定資料、工具權限、推理投入與通過條件;不要一邊換模型、一邊把提示詞也改好,最後卻把所有改善算給模型。
文件題查來源、數字、範本與可編輯性;程式題查關鍵事實與測試;缺檔題查是否清楚交代障礙,並停止把未驗證事項寫成完成。把成功、失敗與重跑全留下,最後比較通過比例、總花費、等待與人工修訂時間。若想把模型和執行層分開,可先讀 Agent Harness 入門;評審如何避免誤獎漂亮答案,則接著看 Actor、Judge、Teacher 的資訊差。
準備開始前,也要先找對入口。官方 Work/Codex 說明 表明這次模型推出適用於 Work 與 Codex,並沒有把兩模型加入一般 Chat;帳戶方案、工作區權限與推出進度會影響何時可選。桌面 App 或 CLI 先更新,再查看自己帳戶的模型選單。API 呼叫則另外走 API 計價。
值得換的理由,是你那份工作在相同驗收下更省、更好交接,而且保留了必要資訊。 先驗一個缺檔任務:它能否明白說出哪裡卡住,會比一段流暢的「已完成」更快告訴你,這次升級能交付多少信任。
接著閱讀
左右滑動查看更多推薦
 內容類型:文章
GPT-6.1 Sol:與 Astra 只差 1 分,成本真能少近八成?(2026)
GPT-6.1 Sol 的外部評測顯示,綜合指標與 Astra 只差 1 分,單題成本約為 0.72 對 3.26 美元。這篇對照官方資料與測試邊界,教你用合格任務的總成本判斷是否值得換模型。
閱讀文章 內容類型:文章
GPT-6.1 Terra 解析:US$0.40 評測成本,離可靠電腦代理還有多遠?(2026)
GPT-6.1 Terra 在 AA 的最高強度評測中增加六分,每題成本從 US$1.40 降至 US$0.40。拆開推理強度、英文綜合指數與桌面操作證據,判斷這次降價如何變成合格成果。
閱讀文章 內容類型:文章
GPT-6 Astra 是 AGI 嗎?OpenAI 自評與獨立跑分落差(2026)
GPT-6 Astra 正式發布,OpenAI 自評 OSWorld、ExploitBench 與 ARC-AGI 高分,獨立評測卻顯示綜合智力與前代接近。本文拆解 harness、成本與 AGI 宣稱。
閱讀文章 內容類型:文章
GPT-6 Sol、Luna 深度解析:便宜一半,不代表更強(2026)
GPT-6 Sol、Luna 把 API 單價壓到前代約一半,但 Artificial Analysis 顯示整體能力大致持平、知識工作甚至退步。這篇拆解成本、Token、拒答與真正的選型方法。
閱讀文章 內容類型:文章
GPT-6 Cyber 解讀:948 個 Linux 提權成果,離真正修好還有多遠?(2026)
OpenAI 推出 GPT-6 Cyber,並公開 Linux 自動化研究的 948 個去重提權成果。拆清公司自報、可重現證據、候選修補與安全評測的界線,看懂防守方接下來該驗什麼。
閱讀文章 內容類型:文章
OpenAI Astra 自評 Critical:100% ExploitBench、兩個零日漏洞解讀(2026)
OpenAI Astra 被公司依自家框架列為首個 Critical 資安模型,並自報 ExploitBench 100% 與兩個零日漏洞。本文拆解 benchmark 分母、受控存取與仍待外部驗證的證據。
閱讀文章