
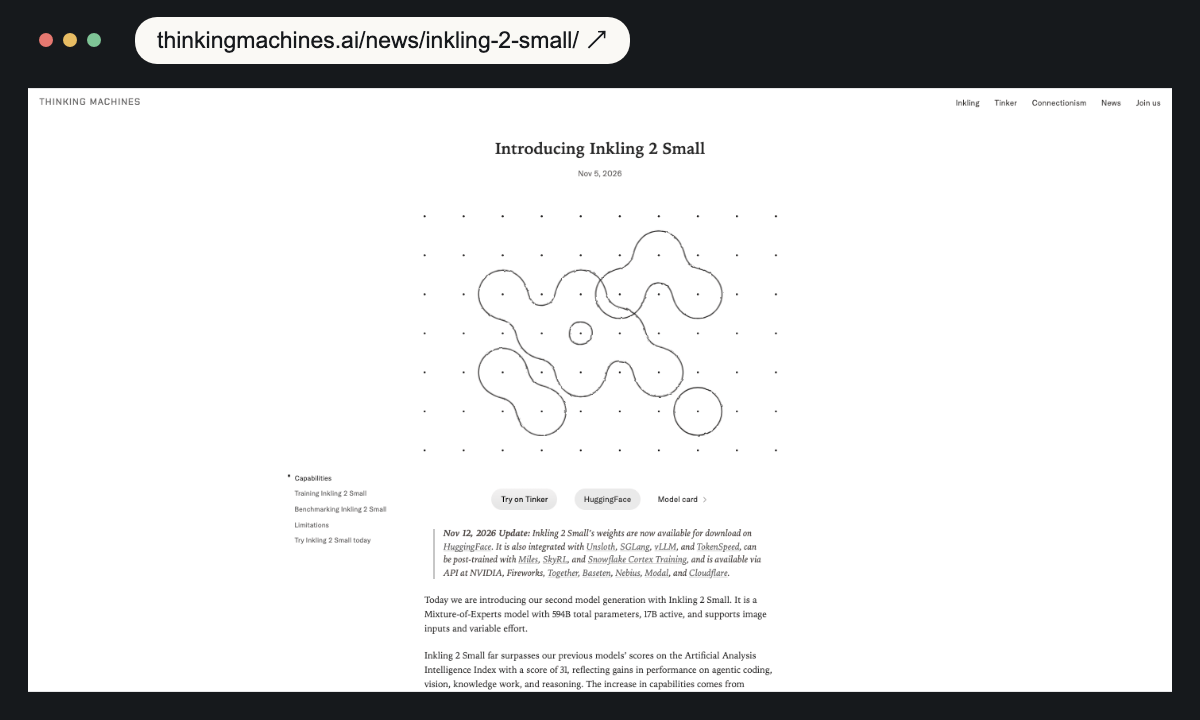
2026 年 11 月 12 日,Thinking Machines Lab 在〈Introducing Inkling 2 Small〉加入更新,宣布 Inkling 2 Small 權重已可從 Hugging Face 下載。原文首發於 11 月 5 日;這次的新進展,是模型檔案的交付,讓原先依賴託管服務的使用方式,多了自行部署與修改的選擇。
先讀這段更新到底承諾了什麼,再核對檔案、授權與引擎文件,最後回答一個採用問題:拿得到權重之後,誰值得把模型接回自己手上?先前的Inkling 2 Small 分數與輸出成本分析已討論能力進步;本篇追的是交付狀態與部署自主性。
一、Inkling 2 Small 權重:從預告,走到可檢查的檔案
Inkling 2 Small’s weights are now available for download on HuggingFace.
中文:Inkling 2 Small 的權重現在已可在 Hugging Face 下載。
Thinking Machines Lab,2026 年 11 月 12 日更新
這句話值得和原文較早的段落分開讀。11 月 5 日的版本先讓模型在 Tinker 提供服務,將 Apache 2.0 權重列為安全測試後的預定交付;11 月 12 日新增的段落,則明確把下載狀態改成已開放,並列出推論、後訓練與 API 生態。原文的精神仍是客製化:讓開發者把模型調整成自己的工作工具。
截至 2026 年 11 月 14 日本篇查閱,官方 Hugging Face 檔案頁已列出 Safetensors 權重分片、模型設定與聊天模板;模型卡標示 Apache 2.0,並連到該授權全文。這比一則「下週開放」的預告,多了可以固定版本、檢查格式與追查來源的交付物。本文查核了公開檔案清單與小型設定檔,未下載完整模型或執行推論。

更新也列出 Unsloth、SGLang、vLLM、TokenSpeed 的推論整合,以及 Miles、SkyRL、Snowflake Cortex Training 的後訓練路徑。這是一張接入地圖;各工具支援到哪一種權重、GPU 與功能,要回到維護者的配方核對。
二、Inkling 2 Small 權重的規模:594B 與 17B 怎麼讀?
模型卡列出 594B 總參數、17B 啟用參數;其 MoE 架構每個 Token 從 384 個專家中選用 8 個。可以把它想成一間有很多專科的公司,每件工作只叫部分人出手。這有助於減少每一步的運算,但其他專家的資料仍屬於整份模型。
因此,17B 不是整份權重的記憶體預算。實際要放多少,還取決於數值格式、不同層的儲存方式、執行器配置與中間狀態。SGLang 的專用部署文件把主檢查點描述為混合儲存:前 40 層的路由專家採 NVFP4,後 8 層採 MXFP8;文件列出的檔案規模約為 394GB。不能把每一個參數都當成相同位元數,直接估算完整交付檔案。
| 官方模型卡列出的檢查點 | 所列 GPU 叢集顯存門檻 | 所列硬體範例 |
|---|---|---|
| 主要 NVFP4 | 合計至少 500GB | 2 張 B300,或 4 張 H200 |
| 替代 MXFP8 | 合計至少 800GB | 4 張 B300,或 8 張 H200 |
這張表適合用來判斷規模,不能單憑總顯存相加,就保證任意幾張卡可互換。卡型、核心支援與通訊方式,都會影響配方。想補上權重之外的記憶體帳,可以讀GPU 顯存量測、模型歸因與 KV 推估。
三、量化版能降低門檻,但要換一份驗收表
也別把「官方主檢查點至少 500GB」改寫成「任何版本都要 500GB」。Unsloth 的 Inkling 2 指南另提供 Dynamic GGUF 路線;其列出的最小 UD-IQ1_S 權重檔約 171.7GB,並提醒還要替作業系統、KV Cache、執行緩衝與視覺投影器留空間。這是另一種量化與執行路徑的檔案數字,並非 171.7GB 記憶體就能滿載運行的保證。
量化把數值表示壓得更省,硬體門檻有機會下降;接著要檢查的是行為。文件上的保真指標有自己的資料與定義,不能直接當成你的繁中問答、工具參數或讀圖正確率。這裡最合理的比較,是固定題目和允許成本,分別留下原始與量化版本的逐題結果。
這也解釋為何「下載到檔案」只是第一關。不同權重格式、聊天模板與視覺組件,要和對應的執行器一起驗收;若用較省記憶體的方案換到了更多等待或更多返工,那也是採用成本的一部分。低 RAM 巨型模型的等待診斷可以幫你把載入、讀題與輸出分開觀察,但該文的 DeepSeek 配方不能直接套給 Inkling。
四、整合已到位,仍要讀清楚支援的是哪一條路
截至本篇查閱,vLLM 的模型專用配方指定 vllm/vllm-openai:inkling-2-small 映像檔,作為支援進入正式版本前的運行方式;SGLang 文件則指定 dev-inkling-2-small 系列映像檔。這些維護者文件支持「已有專用接入路徑」,而不是「隨便安裝手上的舊版就能用」。
Context 也是配置的一部分。vLLM 配方列出在 GB200 上驗證的兩種配置:TP4 對應最高 262,144 Token;TP8 才對應完整的 1,048,576 Token。這是該配方的驗證範圍,不是所有引擎與硬體的共同上限。模型卡的百萬 Token 能力,必須和實際服務啟動的容量一起讀。
甚至同一份權重,推論與微調也可能有不同條件。vLLM 文件說明,這份 NVFP4/MXFP8 檢查點可走 attention-only LoRA;路由專家的 adapter 另要求 BF16 專家權重。「開放權重」「可以回答」「可以按某種方式微調」,各自需要證據。若你的目的只是試模型,先看現成服務是否已足夠;若要修改模型,才進一步核對訓練路徑。
五、Apache 2.0 帶來使用空間,也要分清模型與品牌
官方模型卡明確標示 Apache 2.0。授權原文允許依其條款使用、修改與散布作品;重新散布時,需提供授權副本、標示修改,並保留適用的著作權等通知。這使客製化與產品整合有一份可追查的授權依據。
同一份授權第 6 節也明確區分商標:它不因作品採 Apache 2.0,就一併授予一般的品牌商標使用權。模型檔案可以怎麼用,和能否拿實驗室標誌替產品背書,是兩個問題。下載時應同時保存模型版本、模型卡及適用條款,讓後續修改和交付能追得回去。
權重交付增加的,是接管與選擇的空間。Thinking Machines 在分階段開放的說明中,把託管微調與下載權重視為不同階段:前者讓提供者保留監測與存取控制,後者把更多部署決定交給下游。自行運行有機會把資料處理留在你控制的環境;要實現這個目的,還必須檢查日誌、網路連線、儲存與工具端點。
六、AlphaLab 的判讀:交付自主性,才是這次該加的分
我同意:從承諾變成檔案,是可以對帳的進展
這次值得肯定的地方很具體:開發者可以檢查版本、選推論引擎、評估量化方案,也能規劃自己的微調與保存方式。對需要固定模型版本、控制資料流向或長期維護自訂行為的團隊,這些選擇有實際價值。
我存疑:開放是否會自動變成更省、更安全
硬體、閒置容量、系統維護、測試與事故處理,都會進入自架的帳。現成 API 的單次費用可能看起來較高,卻可能省掉初期維運;有穩定用量與現成叢集的團隊,則有理由把自架列入比較。權重開放日也不是安全認證日:下游仍需要依自己的資料、語言與工具權限驗收。
模型卡把安全評估與限制列為獨立章節,要求部署者按具體用途評估,並在應用層加入保護。對能動工具的系統,應把讀資料、改檔案、連外與執行程式分成可檢查的權限;模型任務答對,不能代替操作是否獲授權。Home Assistant 的唯讀驗證與可還原自動化就是把這個原則落在真實工具上的例子。
下一份有說服力的證據,是可重複的交付紀錄
這次開放本身沒有替每個使用情境提供新成績。接下來最有用的材料,是固定權重與引擎版本後,在相同任務、成本與權限下留下的紀錄:答對多少、等了多久、重試幾次、人工接手多少。比較量化版本時,也要把原本會做、改後退步的題目留下,而不只列成功案例。
七、現在怎麼決定:先寫下你要接管的那一件事
如果你只是想使用模型,先選一份已獲授權的文字材料、一張可核對的圖片與一個低代價任務,利用現成入口看它是否符合需求。若你要自架,先列出接管的理由:資料控制、固定版本、客製化或穩定用量;再依同一份工作考卷比較部署方案。這是建議的選型方法,本篇未執行模型推論。
評估時至少保存四組資料:權重版本與格式、引擎及啟動配置、逐題答案與錯誤、整體成本與等待。已有硬體與授權環境的人,再做小範圍試跑;尚未備妥的人,今天先讀模型卡、檔案頁與對應配方,就能排除不少不相容的假設。
Inkling 2 Small 權重開放,把「能否拿到」往前推了一步;「值得接管多少」仍應由你的工作決定。先找出一項託管服務難以滿足、而權重交付確實能改善的需求,再投入部署資源,這份自主性才有明確用途。
接著閱讀
左右滑動查看更多推薦