
2026 年 11 月 11 日,QwenCloud 在官方模型更新中公布 Qwen4-Max 預覽,並以〈Latest model: Qwen4-Max-Preview〉交代規格與存取條件。這次值得讀的,是百萬 Token、多模態與工具能力之外的一行安排:預覽結束後,這個版本會退役。
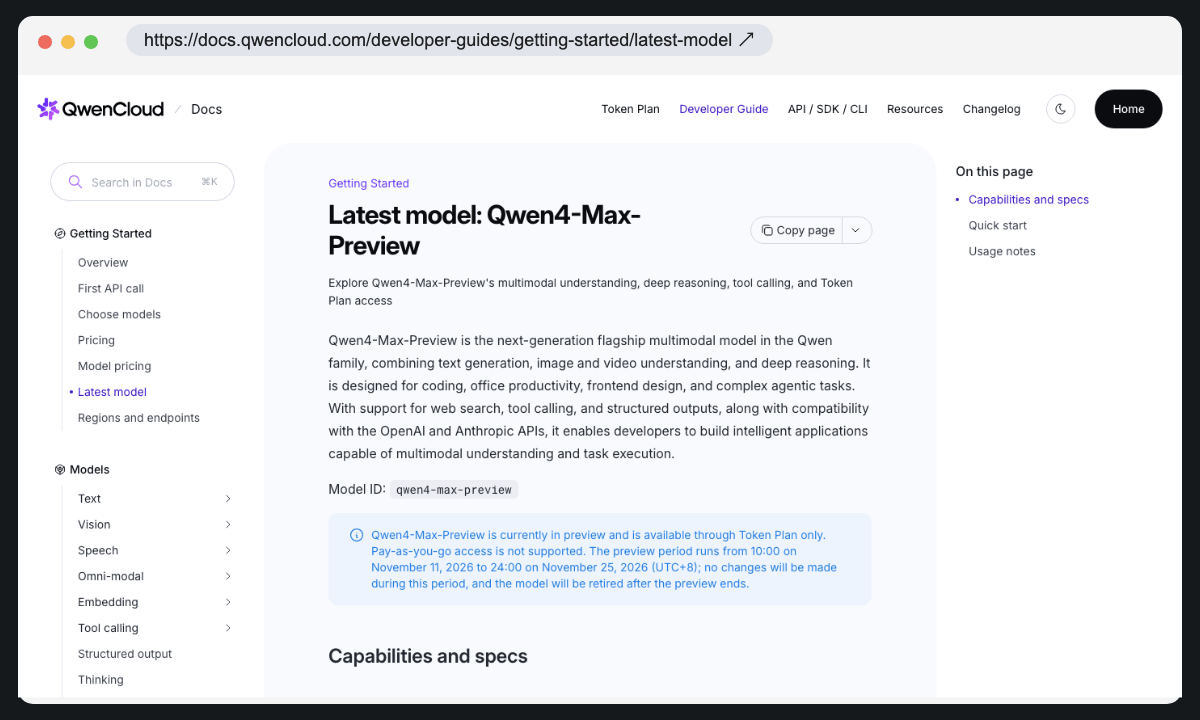
先把原文承諾與限制讀完整,再看哪些能力仍待證據,最後決定這段預覽期值得拿來做什麼。本文分析官方文件與公開研究,未呼叫此模型取得自測成績。
一、Qwen4-Max 預覽開放了什麼?先分清規格與成績
官方模型更新紀錄把這次發布列在 11 月 11 日。原文將它定位為新一代旗艦多模態模型,面向程式、辦公、前端與複雜 Agent 工作;這是供應商對用途的定位,尚不能替任何人的實際任務打分。
| 官方列出的項目 | 文件內容 | 評估時還要問 |
|---|---|---|
| 輸入/輸出 | 文字、圖片、影片輸入;文字輸出 | 是否讀對表格、畫面與時間關係? |
| 上下文 | 1M Token | 相關證據放在不同位置,答案仍一致嗎? |
| 最大輸出 | 393,216 Token,推理與答案共用 | 完成一件工作,實際耗多少與等多久? |
| 工具與格式 | Function Calling、搜尋與內建工具、JSON Object/JSON Schema | 參數、工具回填及最後資料狀態是否正確? |
| 協定相容 | Chat Completions、Responses、Anthropic Messages | 既有客戶端的參數語意與歷史回填是否對得上? |
上表可在官方模型規格表交叉核對。「多模態」在這裡首先描述可讀哪些輸入;別直接把理解圖片與影片,延伸為這個模型也能生成圖片與影片。選模型前,先寫出你真正要交付的產物。
原文的核心訴求,是把看圖、讀長材料、推理與工具操作放進同一條工作鏈。這有吸引力:例如根據介面截圖與需求文件修改前端,再核對結果。但能力清單仍只是起點;每一段都接得上,最後才有一份可交付的作品。
二、11 月 25 日不是一般促銷截止:預覽版會退役
Pay-as-you-go access is not supported.
中文:不支援按量付費存取。
QwenCloud,Qwen4-Max-Preview 文件
截至 2026 年 11 月 12 日查閱,原文與Token Plan 個人版文件一致列出:預覽自 11 月 11 日 10:00 至 11 月 25 日 24:00(UTC+8);期間模型不變,結束後退役。24:00 指的是 25 日當天結束,也就是 26 日 00:00,別讀成 25 日剛開始。
期間不變,有助於把同一版模型的多輪結果放在一起比較;退役,則代表你得把退出安排一起寫進試驗。不能從這份預覽條款,推定它之後會自動換成某個正式版、沿用相同價格,或保住相同輸出。
更直接的邊界藏在使用範圍。官方相容工具說明明列,個人與團隊 Token Plan 支援的範圍是 AI 程式工具及相容 Agent,排除自動化工作流平台、API 測試工具、自訂自動化腳本與應用後端。兩版方案的條款也都限定工具內的互動使用。有 API 協定與金鑰,不代表取得了任意後端或排程呼叫的使用資格。
因此,這次適合安排在合規工具內、由使用者互動發起的模型比較。團隊方案的席次與管理功能,可以到團隊版文件核對;它不會自動解除上述用途限制。若你的需求本來就是無人批次服務,先解決可用服務與授權範圍,別照著一般相容 API 範例就開跑。
三、百萬 Token 是容量;讀懂長材料,要另交一張考卷
把長上下文想成一張很大的桌子:能攤開更多頁,對程式庫、多份文件和跨畫面工作很有幫助。但桌子大,不等於每條註腳都被用對。你真正需要的,可能是找出兩份規格的矛盾、追到某項需求的例外,或拒絕採用已作廢的版本。
這個區分有獨立研究背景。Nelson F. Liu 等人的〈Lost in the Middle〉研究在多文件問答與鍵值檢索中,觀察到受測模型表現會隨相關資訊的位置改變,中段材料尤其容易造成退步。那是 2023 年研究中那些模型與任務的結果,不是 Qwen4-Max 的測試,也不能推論新模型一定重犯相同錯誤。它提供的是一個值得保留的考題。
評估時可以手動準備三份內容相同、證據位置不同的自有材料,把關鍵條款放在前段、中段與後段。請模型給出結論及可回查的原文位置,再加入一份舊版或相似但不適用的段落,觀察它是否能分辨。這是建議的測試設計,並非本文已執行的實驗。
還要比較「交出相同合格答案」所需的用量與時間。一次塞入全部材料、先整理相關段落,可能有不同取捨;不要先把容量用滿,再拿一個正確答案證明容量划算。需要建立評分規則,可接著看 AI Evals 入門;理解多題共享材料的另一種效率問題,則可讀 Flide 的工作負載比較。
四、Qwen4-Max 預覽的細節:思考和答案共用輸出預算
Both limit the combined tokens for thinking and the final answer.
中文:兩者都限制思考與最終答案的 Token 合計。
QwenCloud,原文 Usage notes
這裡的「兩者」是 max_tokens 與 max_completion_tokens。官方 API 相容性更新通知在 11 月 2 日已寫出規則:從這個新模型開始,Chat Completions 的兩個參數等價,計入推理加答案;較早模型保留原行為。
想像你把一個請求的合計上限設為 8,000 Token,而該次推理用了 6,000;留給答案的空間就至多約 2,000。這是說明預算如何分配的假設算例,不是模型的典型用量。若舊設定原本只替答案留空間,換模型後便可能提早用盡預算。
同理,393,216 的最大輸出規格,也不能讀成「另外還能寫這麼長的最終答案」。原文把思考預設為開啟,列出 low、medium、xhigh,預設 xhigh;並提醒不要同設 reasoning_effort 與 thinking_budget。比較時若只記模型名,漏掉推理檔位,就可能拿不同投入的結果互比。
原文還特別要求多輪 Chat Completions 的歷史思考放回 reasoning_content,不要串進 content。這提醒我們:相容協定降低了接線門檻,但參數、回傳欄位與歷史訊息的處理仍要逐項核對。
五、工具、JSON 與影片理解,各自需要自己的驗收
工具呼叫可分成三件事:模型選出工具,程式執行工具,模型根據回傳繼續工作。第一步輸出一份看似合理的參數,不能替後兩步作保。以根據截圖修正網頁為例,應同時看它讀到哪個按鈕、改了哪些檔案、測試是否通過,以及最後畫面是否符合需求。
JSON 也是如此。一份可以解析的物件,只先過了格式關;日期、數量、引用與要寫入的目的地仍要逐項檢查。比較模型時,把「格式正確」「內容正確」「工具動作正確」分欄,才看得出新能力改善哪一段。
影片題則要分清單幀辨識與跨時間理解。可以用自有短片詢問事件順序、某個動作發生前後的狀態,再回看原片。先確認工具真的把影片交給模型,而非只截了一張代表圖。若要理解模型與執行層各自負責什麼,Agent Harness 的白話介紹與最小 Harness 拆解可以補足這層分工。
截至本次查核,本文取得的材料足以核對官方開放與規格聲明,但未取得可據以判定 Qwen4-Max 相對其他旗艦模型優劣的獨立公開實測。因而不給它「最強」名次,也不把使用者的展示轉寫為普遍成功率;本文同樣不從這次雲端預覽推定可下載權重或本機部署資格。
六、AlphaLab 的判讀:把短期開放,換成能帶走的證據
我同意:把多種能力放在同一個真實問題上比較
這次值得關注的,是多模態、長材料與工具操作能否在同一項工作互相補足。對需要看介面、查文件再修改程式的人,分段各有能力,未必等於整段能交件。預覽提供了一次評估機會,最有用的成果是一份自己的工作紀錄。
我存疑:旗艦定位能否直接變成選型結論
供應商想把模型定位到高價值任務,有清楚商業動機;這不會讓規格自動失真,也不會替能力提供外部驗證。我會先問:同一份材料、相同交付要求下,它少犯了哪一類錯、用了多少資源、需要多少人工返工?能回答這三題,才比一句「更會推理」接近決策。
預覽期限反而讓試驗目標更清楚:保留可以搬走的東西
不要把試驗成果綁在預覽 ID 上。保留去識別的輸入、明確答案本、推理設定、工具回傳與失敗類型;未來出現正式版或其他候選,都可再用同一份考卷比較。這些東西比一段漂亮回答更耐用,也讓退役不至於變成整個工作方法歸零。
下一步:在相容工具內,手動完成一個小型對照
選一件你有權處理、能回查對錯的工作,例如根據三頁自有規格與一張介面截圖,整理出五項修改要求。先寫答案本,再由你在合規工具內分別發起現用模型與預覽版的互動任務;固定材料與驗收,記下遺漏、錯引、工具失敗、時間與實際用量。別因為預覽快結束,就省略對照。
準備資料時也要先看跨境傳輸與用途。Token Plan 個人及團隊文件都列出新加坡區域與 Global 部署,推論會在全球執行;「選到新加坡」不能直接推成「資料只在新加坡處理」。先用可公開或獲准的測試材料,把個人資料與正式金鑰留在模型輸入之外;Agent 密鑰安全可接著檢查這條資料路徑。
Qwen4-Max 預覽最值得帶走的,是一份足以判斷下一個版本的考卷。11 月 25 日之前,先讓它證明一件小事;之後無論模型名稱怎麼換,你仍知道什麼才算完成。
接著閱讀
左右滑動查看更多推薦
 內容類型:文章
Qwen3.8-Max 成為模型發布潮焦點|2.4 兆總參數、低價 API 與開放權重承諾(2026)
Qwen3.8-Max 已上線 QwenCloud API,官方稱 2.4 兆總參數、95B active 與 1M context;Max 權重預告下週公開,27B 也將開放權重但未明定時間。本文核對價格、benchmark 與長任務證據。
閱讀文章 內容類型:文章
Qwen3.8-Omni-Flash:長影音成為 Agent 輸入,真正突破在哪?(2026)
Qwen3.8-Omni-Flash 把長影音接進 Agent 工作流。本文拆解 1M context、Realtime、Plugins、Harness、benchmark 與價格主張,判斷突破來自模型還是整套工具鏈。
閱讀文章 內容類型:文章
Qwen3.8-27B 本機 Agent|80 次工具呼叫證明了什麼?(2026)
Reddit 使用者回報在單張 RTX 3090 上執行量化 Qwen3.8-27B 本機 Agent,80 次工具呼叫後產出大學課表。本文查核模型規格、硬體可行性、harness、重現性與憑證風險,說清楚一次成功真正能證明什麼。
閱讀文章 內容類型:文章
Qwen3.8-2.4T-A95B 開放權重:5TB Max 級模型代表什麼?(2026)
Qwen3.8-2.4T-A95B 公開 2.4T 總參數、95B 啟用參數與約 4.9TB BF16 權重。本文查證授權、262K/1M context、硬體門檻,以及它為何是開放權重而非完整開源。它不是一般人的本地模型,也不是完整商用 Max。
閱讀文章 內容類型:文章
Gemini 4 Hydrogen 解讀:四種思考檔位,怎麼看速度、成本與 Agent 成績?(2026)
Hydrogen 的快,來自模型、思考深度,還是整套 Orchestrator?拆開 Google 自報的 19% 與 24%、百萬共用視窗及外部評測,判斷哪種配置值得先試。
閱讀文章 內容類型:文章
【2026 最新】Neuron Steering 是什麼?用 Qwen 小模型學會神經元干預、對照與撤回
改一個 activation,回答變了,代表找到概念開關嗎?用 Qwen 小模型學會固定版本、正負劑量、隨機對照與 hook 撤回,把風格偏移和能力損傷分開看。
閱讀文章