
2026 年 11 月 5 日,Hao Yu 等研究者在 arXiv 發布了論文〈SplatAnything: Gaussian Spacing Normalization for Feed-forward 3DGS across Arbitrary Scenes〉。這篇 SplatAnything(InfiniSplat v3) 研究把問題指向一個容易被忽略的地方:模型用照片重建 3D 場景時,學習「每一筆要畫多大」的尺,是否在不同場景裡代表同一件事?作者來自浙江大學、騰訊混元與 Causa Robotics。

先看原文提出的機制,再讀實驗真正比較了什麼,最後判斷它離可用的 3D 世界還有多遠。結論先放在這裡:GSNorm 提供了有說服力的訓練座標設計;它改善的是跨場景預測的條件,不能直接充當完整場景、真實尺寸或導航安全的保證。
一、SplatAnything 想解決的,是同一種筆觸遇上不同的尺
先把 3D Gaussian Splatting(3DGS,高斯潑濺)想成很多半透明、帶方向的彩色筆觸。每一筆有位置、大小、朝向、顏色與透明度;從某個相機角度把它們畫在一起,就形成一張場景影像。Kerbl 等人的 2023 年原始研究以這類表示搭配逐場景最佳化與快速渲染,推進了新視角合成。這裡的「能從另一角度看」與「拿到精確工程模型」,是兩種需要各自驗收的成果。
前饋式方法則把不少工作搬到訓練階段:讓一個模型看過許多場景後,接收新照片便預測高斯表示。這條路早有 pixelSplat 等研究。SplatAnything 的新意,集中在幾何預測和高斯屬性預測之間的尺度參照,而不是「首次把照片變成 3D」。
論文討論的常見做法,是先以場景中的平均徑向距離做縮放,稱為 RDNorm。這有助於固定一個整體幾何統計量,但高斯預測更在意另一件事:相鄰像素反投影到三維後,兩個高斯中心離多遠?鏡頭視野、觀測距離與取樣方式改變時,固定前一種統計量,不保證後一種也一致。
若筆觸比中心間距小太多,表面容易露出空隙;若筆觸過大,又容易重疊、糊掉細節。這就像同一位畫師在不同格距的紙上作畫:只把畫紙外框縮成一樣大,未必能統一每格該用多粗的筆。這是理解原文動機的比喻,不是每個畫面缺陷的唯一成因。
二、GSNorm 怎麼改:對齊代表性間距,保留局部差異
Canonicalizing the median Gaussian spacing gives predictions a more consistent spatial reference across scenes.
中文:把高斯間距的中位數統一,讓跨場景預測有較一致的空間參照。
SplatAnything 官方研究頁,Normalization space
在論文的針孔相機推導裡,先假設相鄰像素附近的深度近似不變。水平間距約為深度 D 除以像素焦距 fx;把水平與垂直方向合併,可寫成 d ≈ D / √(fx × fy)。它描述的是取樣間距的一階近似,深度邊界或斜面仍需要留意近似的適用程度。
GSNorm 從所有有效觀測取得這個量的中位數,作為整個場景的縮放因子;深度、三維點與相機平移共同換到新的尺度。論文把代表性間距的目標寫為 1。統一的是一個場景層級的參照,不是把每個局部間距都硬改成相等。遠近關係與局部幾何差異仍然保留。
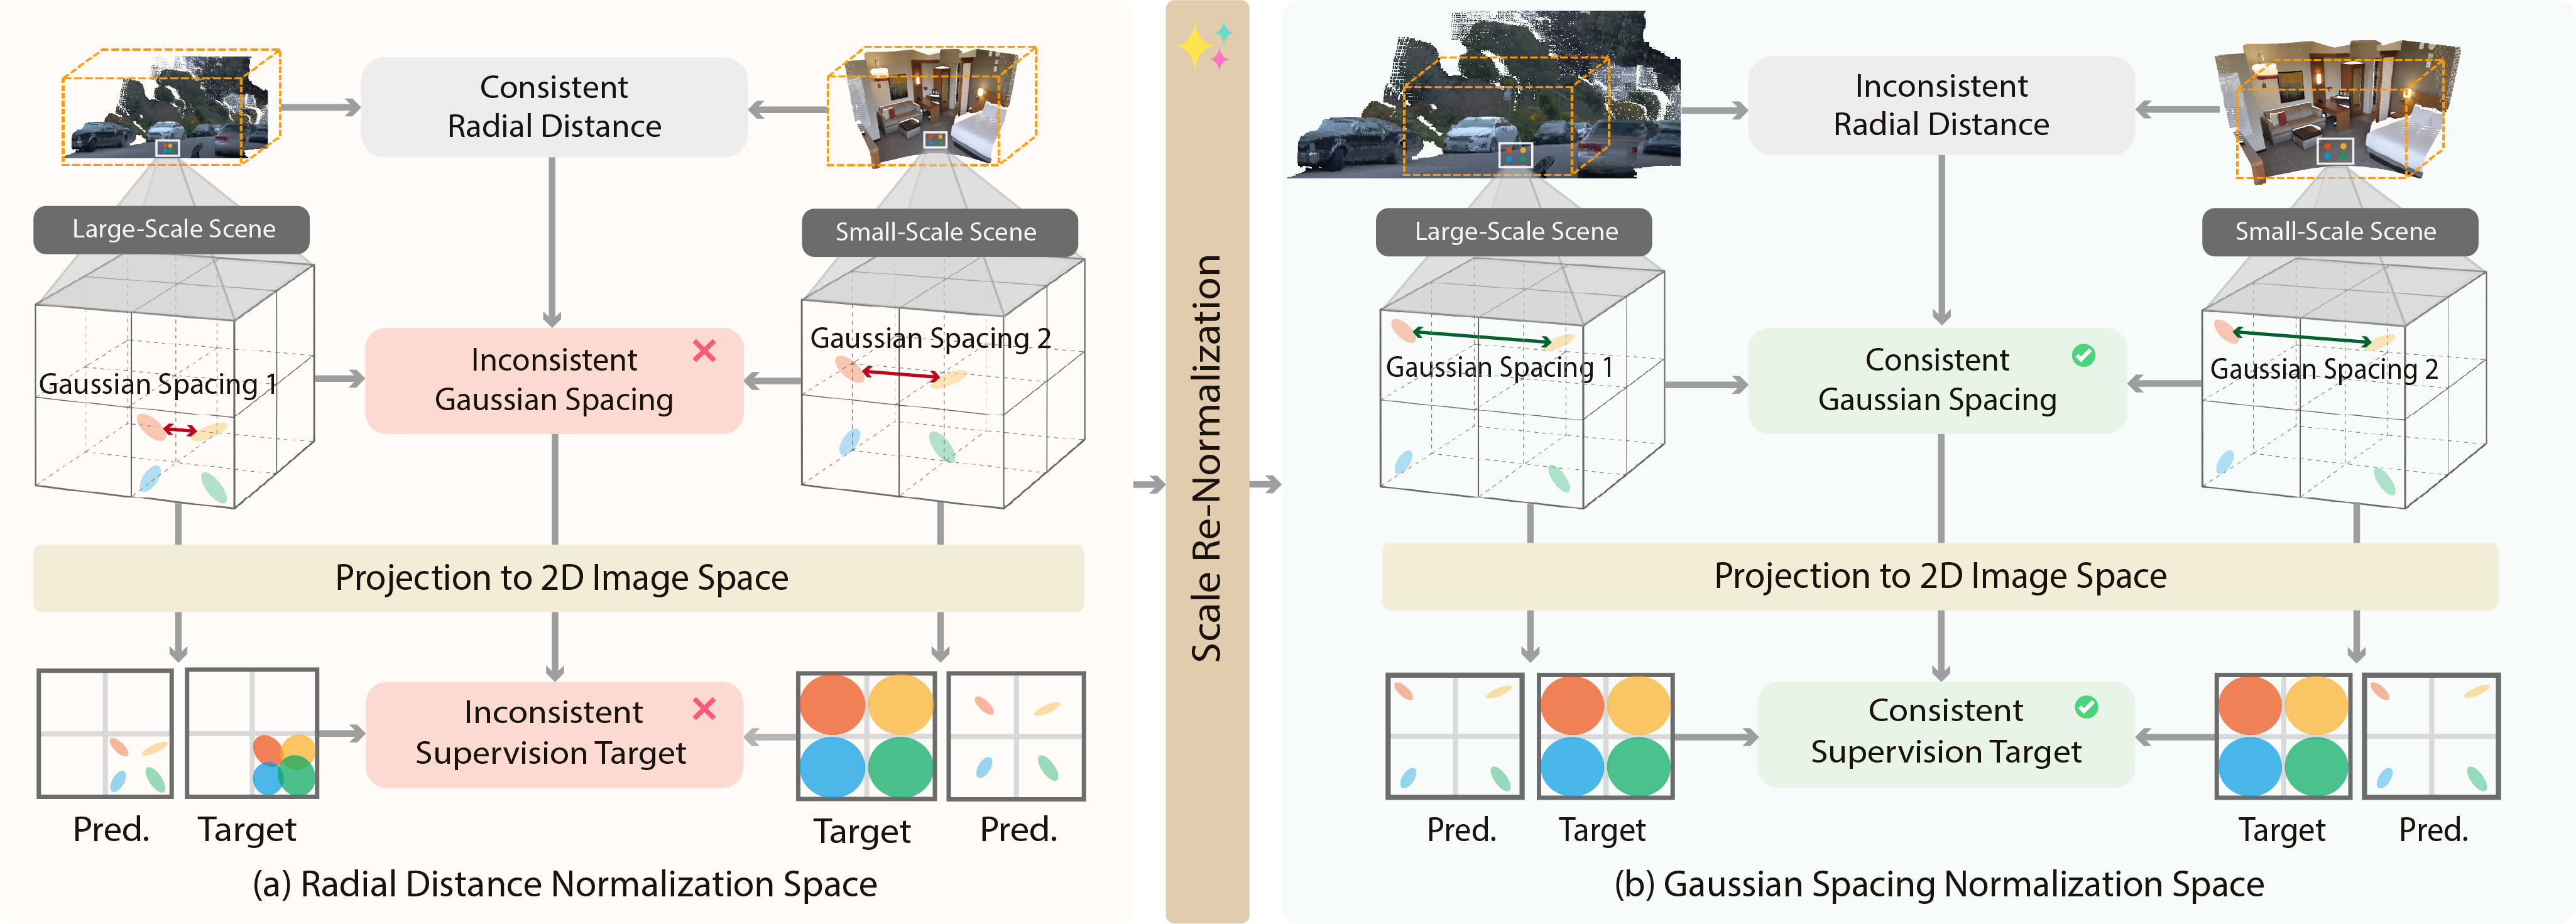
這張圖真正要表達的是「先讓模型在較一致的條件下學習」。它不是在主張把舊模型輸出的所有高斯一起放大或縮小,就能得到相同成果。論文也專門比較了事後尺度校正,接下來的消融才是檢驗這個區別的地方。
三、整套架構還做了什麼?歸一化不是全部能力的來源
依原文第 3.4 節,SplatAnything 先以凍結的 WorldMirror 2.0 幾何模型估計深度與相機資訊,再把相關幾何換到 GSNorm 空間。另一個從幾何骨幹初始化、繼續微調的 Gaussian Backbone,加上從頭訓練的 GSHead,負責預測高斯的透明度、旋轉、大小與外觀係數;中心則固定在反投影幾何上。
此外,附錄描述了合併重疊高斯的 voxel merging,以及不同相機軌跡和目標視角的訓練取樣。這些設計處理不同問題:一致的間距參照協助學習高斯大小;合併處理多視角累積的冗餘;幾何先驗決定中心大致在哪裡。因此,完整模型的排名不能全部歸功於一條歸一化公式。
這也是消融實驗的價值:若要知道 GSNorm 自己貢獻多少,應比較相同架構、相同訓練設定,只改尺度空間的組別;不能拿兩套各有不同骨幹與資料的模型,直接把全部差距算到 GSNorm 頭上。
四、SplatAnything 的成績怎麼讀:先看作者控制了哪些條件
作者建立的評測涵蓋七個資料集:ScanNet、NRGBD、DL3DV、Tanks & Temples、Mip-NeRF 360、ETH3D 與 DTU。多視角部分比較 4、8、16、32、64 張輸入,另有單張輸入評測。設計上的重點,是多視角各組維持同一段相機軌跡範圍,再提高觀測密度,避免「照片更多」同時偷偷變成「看見更多區域」。
目標視角挑在輸入軌跡段外,並以考慮遮擋、雙向計算的共同可見性控制難度。作者設定的區間是 0.20 ≤ Csym < 0.60;這是該協定的幾何重疊量,不應直接翻成「模型補出了其餘百分比的真實世界」。
最能對上核心機制的是表 3 的歸一化消融。以下只取其中 16 張輸入的一欄;都是作者報告的實驗結果,並非 AlphaLab 本機重跑:
| 相同架構下的尺度空間 | DISTS ↓ | LPIPS ↓ |
|---|---|---|
| RDNorm | 0.218 | 0.268 |
| RDNorm+事後尺度校正 | 0.245 | 0.300 |
| GSNorm | 0.190 | 0.232 |
在這一欄,GSNorm 相較 RDNorm 的 DISTS 約低 12.8%、LPIPS 約低 13.4%。這是由表中數值計算的指標相對降幅,不是「畫質提升百分比」,也不是幾何精度的提升幅度。事後校正這組在兩項指標反而較差,支持作者的解釋:預測前的學習參照,與預測後把尺度調一調,並非同一件事。

兩個指標各有自己的任務。LPIPS 原作者文件說明它比較影像區塊的感知距離;DISTS 原作者文件則把結構與紋理的相似度納入影像品質評估。這些外部一手資料能確認指標在量什麼,卻不會替 SplatAnything 的全部成績提供獨立背書。
五、「跨任意場景」要讀成研究目標,逐格成績才是證據
論文的完整比較相當值得追,但別把標題裡的 arbitrary scenes 讀成每一格都贏。以單張輸入的表 2為例,在 ScanNet 上,SHARP 的 DISTS/LPIPS 是 0.223/0.244,SplatAnything 是 0.238/0.274;這兩項都是較低較好。作者自己提供的表,就足以反駁「單張照片也全面領先」的讀法。
同樣地,「幾秒完成」需要帶上測試條件。附錄 A.7 與表 11 報告單張 NVIDIA H20、BF16、batch size 1、輸入影像統一為 448×896 的每場景前向延遲中位數。無輸入位姿的一組,4 張輸入為 411 毫秒,64 張則為 11,037 毫秒。這不是消費級筆電的速度承諾,也不等於包含讀檔、匯出與互動渲染的總時間,更不能拿來當每秒畫面數。
這裡最公平的結論是:作者報告了跨資料集與外插視角下有競爭力的結果,也提供可直接檢查的控制實驗;普遍品質、成本與適用範圍,仍應逐個設定核對。Hugging Face 的 討論頁顯示它獲得社群注意;投票與排名是關注訊號,並不是重現紀錄。
六、原文自己留下的界線:看不到的地方,仍可能是空的
It also primarily reconstructs regions visible in the input views, which can leave holes in unobserved areas.
中文:它主要重建輸入視角可見的區域,因此未被觀測的區域仍可能留下破洞。
Hao Yu 等,SplatAnything,第 5 節 Limitations and Future Work
這句話應該和所有漂亮展示一起讀。原文也指出,當極稀疏或困難輸入使幾何估計不可靠,品質可能下降;未來方向包括改善幾何估計與用生成式先驗補未觀測區域。也就是說,作者把「可靠地重建看見的部分」和「補全沒看見的部分」留在不同的證據層級。
尺度也要分開看。論文附錄的無位姿評測,會利用預測與真實來源相機之間的場景層級相似變換,先對齊高斯,再到真實目標相機渲染。這個程序有助於在共同座標下比較影像;它不能直接證明模型在部署時就知道一張桌子的實際公尺尺寸。官方輸出文件也區分了幾何模型的深度尺度與匯出點雲的歸一化尺度。
研究庫把自駕、機器人導航、AR/VR 與遊戲列為應用方向,也提供環景相機與全景重建入口。值得探索,但若下一步是機器人移動,就應加測距離、障礙物邊界、遮擋與失敗情境;若下一步只是可瀏覽的視覺內容,則可先評估重訪視角、破洞和匯出品質。兩種用途可以分享重建方法,驗收門檻卻不同。
七、AlphaLab 的判讀:有價值的進步,來自把學習目標放對位置
我同意:跨場景泛化也可能卡在「尺」,而非模型不夠大
這篇最有啟發性的地方,是把不一致的監督目標具體化。若相似局部觀測在不同座標慣例下,要求不同的高斯大小,模型便得同時學會外觀與那套慣例的補償。用與表面覆蓋更直接相關的間距作參照,有清楚的幾何動機;同架構消融也比單純發布更大的模型,更能回答「改了什麼」。
我存疑:能否把一組好看的視角,延伸成整個世界可用
我不會從目前這組證據,把「可外插地渲染」推成「未觀測部分已還原」,也不會把影像感知距離推成導航幾何誤差。這個疑問並不否定 GSNorm;它是在要求下一個用途提供自己的證據。World Labs Atlas 的分析也討論過鏡頭可控與物理理解的距離;看 3D 研究時,這兩張考卷同樣需要分開。
下一份最有說服力的進展:讓別人用同一份設定重跑
原始論文、官方程式與可下載權重,讓研究者有材料往前查。真正能增加信心的後續,是固定版本、相同資料切分、相同輸入位姿條件與相同目標視角後,保留全部失敗案例的外部評測。本文採原始公開實驗作分析,未在 NVIDIA GPU 執行重建;因此不給 SplatAnything 冠上 AlphaLab 實測勝出的結論。
八、現在能做什麼:先為自己的用途寫一張小考卷
想讀懂研究的人,先把三項問題寫在旁邊:這次改的是座標參照、幾何骨幹,還是資料?比較的是單張、多張、有位姿,還是無位姿?成績量的是渲染影像、真實尺寸,還是任務成功?能答清楚,再看展示就比較不會把不同能力加成同一個神話。
有既有相容 GPU 與自有影像的人,可以先選一個靜態小場景,固定輸入照片、相機資料與解析度,再保留未送進模型的目標視角,記下破洞、邊緣漂移、完整處理時間和匯出檔案。若需要尺寸,就另外用已知長度核對座標與比例。這是建議的驗收設計,不是本文已完成的重現結果。
若你還沒走過照片到可瀏覽場景的流程,可先讀 InfiniSplat v2 教學建立基本概念,再依 v3 的官方文件重新核對安裝、模式與輸出;兩版的指令和預設不要互套。想交付的是物件資產,則接著看 圖片轉 3D 資產的工作流,先確認需要的是場景表示還是可編修物件。
SplatAnything 值得追蹤的承諾,是讓不同場景的高斯預測有較一致的學習參照。下一次看到「照片變世界」,先找出那把尺,再問哪些地方真正被看見、哪些結果有人對過帳;這比先相信或先否定「任意場景」更有用。
接著閱讀
左右滑動查看更多推薦
 內容類型:文章
4DAnyone 深度解讀:一段影片真的能變成自由視角 4D 人物?(2026)
一段未校正的單鏡頭人物影片,真的能變成自由視角 4D 人物嗎?拆解 4DAnyone 的方法、作者數字、公開程式碼與重現缺口。
閱讀文章 內容類型:文章
HexaShell 機器人研究:會修程式,為何精細插入仍卡關?(2026)
HexaShell 把機器人失敗修成可重用工具。從 39.7% 總分與 8.3% 精細插入成功率,拆開模擬條件、測試分母與開源範圍,判斷程式修復離可靠動作還差什麼。
閱讀文章 內容類型:文章
RIDE 模型蒸餾:學生四組平均分超過老師,勝負有多穩?(2026)
RIDE 作者報告四組數學推理平均分略高於老師,但三組差距小於訓練種子波動。拆解表徵外推、對照實驗與公開重現的邊界。
閱讀文章 內容類型:文章
VibeWorlding 深度解讀:作者稱 30B 勝 GPT‑5.5,為何還不能下結論?(2026)
VibeWorlding 把 3D 世界建造成可訓練的 Agent benchmark;但作者自報的 59.3 分、評分器循環與公開程式仍有多個待對帳缺口。
閱讀文章 內容類型:文章
CUA-Master 解讀:影片如何變成訓練任務,80.2 分證明了什麼?(2026)
CUA-Master 把教學影片轉成可組合、可驗收的電腦操作任務。拆清 80.2 與 36.9 的測試設定,以及強標註模型、快照重試和訓練成本的證據界線。
閱讀文章 內容類型:文章
JEPA 表徵對齊解析:42 倍樣本差距,離「理解世界」還有多遠?(2026)
Balestriero 與 LeCun 用同場景的不同描述改善跨模態表徵。讀懂 42 倍樣本比較、1.09 億參數模型、理想化定理,以及生成描述與測試選擇帶來的限制。
閱讀文章