
2026 年 11 月 17 日,Microsoft AI 在官網發布了〈Seven new world class models at scalable price-performance〉,把 MAI Code 2、資安、影像與語音模型放上 Ignite 舞台。最醒目的宣稱是:在四項指定程式評測的平均比較中,Code 2 達到 GPT-6.1 Sol 約 98% 的表現、花費約四成。這是微軟選定條件下的評估,成本還採用了五折促銷價。
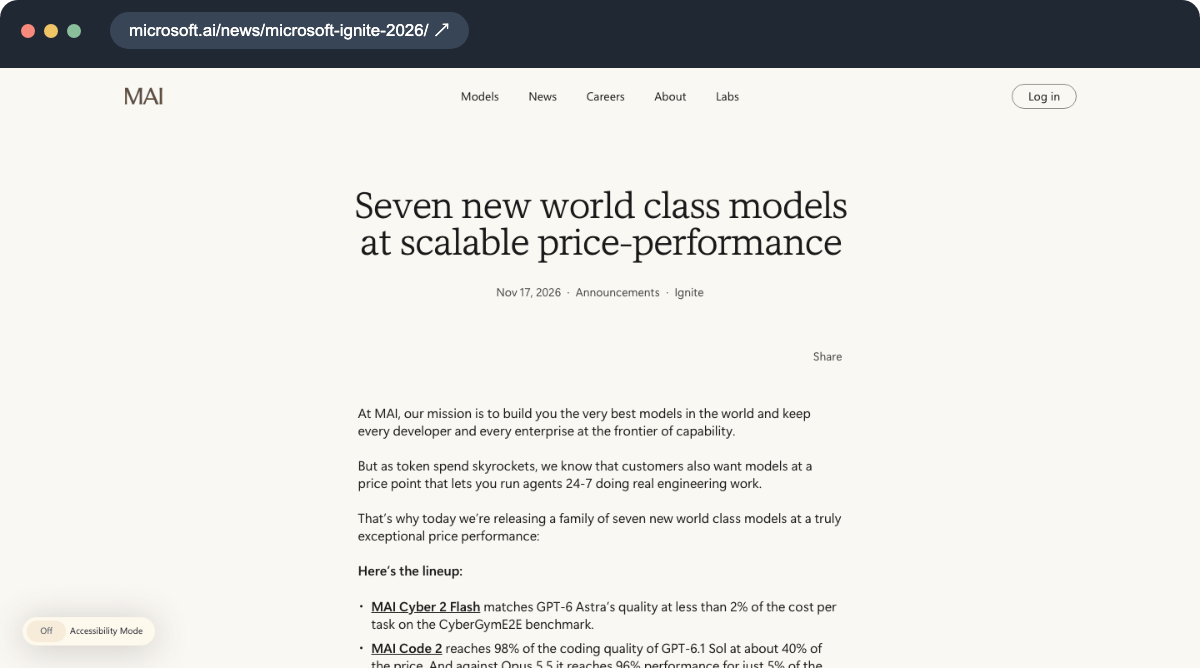
這篇公告真正串在一起的是兩個承諾:讓日常工作用得起專用模型,再讓企業把模型調整與部署的控制握得更緊。下面先整理原文的產品分工,再拆開成績與價格的條件,最後判斷「便宜」與「可掌控」各自需要哪一份證據。
一、MAI Code 2 的主張:把日常工作拆給不同模型
原文以七項新模型為發布主軸,後文另介紹 Image 2.7 Flash 等延伸產品。與其硬湊一個總數,更有用的是看分工:Code 2 對準深度除錯、多檔修改與整個程式庫的推理;Code 2 Flash 對準解釋程式、局部修改與例行修正。Cyber 2 Flash 做資安工作,Image 2.7 做影像生成與編輯,Realtime 1 做即時語音對話,Dragon Copilot Transcribe 承接醫療對話轉錄,Decision 1.1 則負責決策與模型路由。
路由可理解為分診:先辨認工作,把適合的請求交給相應模型。原文要推銷的不是每一題都使用同一顆最大模型,而是一組能依任務調整的供應。這個方向與其產品布局相連:微軟表示,另從 Code 2 Flash 衍生 MAI Work Flash,服務 Microsoft 365 與 Fabric IQ 的情境。這是公司的產品與內部評估陳述,不能直接視為每位使用者的效率提升。
They’re explicitly not yet tuned for harder problems, like fundamental science research and very long horizon agentic work.
中文:微軟明確表示,這些程式模型目前的調校重點,還不是基礎科學研究與非常長程的 Agent 工作等較難問題。
Microsoft AI,原文的程式模型段落
這句自我界定比「接近旗艦」更有用:日常工程與前沿研究的任務分布不同。模型在常見工作上做得划算,並不需要同時證明它能承接每一種長程探索。把這個邊界帶進選型,才是忠實閱讀原文。
二、MAI Code 2 的 98% 與四成成本:先讀腳註
依 Code 2 詳細發布頁,98% 的比較來自 DeepSWE 1.1、Terminal Bench 2.1、SWE-Atlas 與 FrontierCode v1.1 四項程式評測的平均。這是相對某個對照模型的評測表現,不是「98% 的任務都會成功」,也不是人類工程師工作能力的 98%。
腳註還交代:模型都使用最高推理投入;前三項在微軟內部 MSBench 上,透過 GitHub Copilot CLI、未使用子 Agent 執行;FrontierCode 1.1 的分數與成本引用 Artificial Analysis。最容易漏看的條件是,MAI Code 2 的成本採 50% 促銷價。因此整組數字應標為微軟彙整的指定配置比較,不能因其中一項來自外部評測,就把四項平均稱作獨立審計。
MAI-Code-2 cost is shown at its 50% promotional price.
中文:圖表中的 MAI Code 2 成本,採用五折促銷價。
Microsoft AI,Code 2 詳細發布頁腳註 1
可以做一個有限的算術檢查:若其他單價、Token 用量與測試條件都不變,把 MAI 自身的五折價恢復原價,原本相當於對照四成的花費會變成約八成。這是價格敏感度示例,不是新的實測結果,也不是預測未來售價;它說明促銷本身就是優勢的一部分,不能把整個差距都歸給模型效率。
同一頁也宣稱 Code 2 相對 Opus 5.5 的指定評測平均約為 96% 表現、5% 成本,Flash 則在三項日常程式評測與 GPT-6 Luna、Haiku 5.5 比較。這些仍是帶有推理設定、題目與計價條件的供應商數字。本文不把它們擴寫成通用能力等價,也不把比例當作 Copilot 訂閱費會直接打幾折。
三、現在能在哪裡用?把 Copilot、Foundry 與預告分開
GitHub 11 月 17 日的產品更新確認兩款模型已進入 Copilot:Code 2 對應 Pro、Pro+、Max、Business 與 Enterprise;Flash 另涵蓋 Free 與 Student。GitHub 也說明這兩款模型依用量計費,符合資格的年繳訂閱者亦可使用;企業使用者還要看管理員的模型政策。這份產品端公告支持「已有供應入口」,並不獨立證明微軟的成本或品質比例。
Foundry 則應讀更細:截至 2026 年 11 月 18 日查閱,Code 2 詳細頁把 Code 2 Flash 列為 limited-access preview,即有限存取預覽。原文說未來會走向 OpenRouter、Vercel 等通路,應保留為後續計畫。已在一個產品上線,不能推成所有 API 與所有帳戶都可立即部署。
對開發者而言,模型名稱、實際可用入口、組織權限與計價方式要一起確認。若平常在現成 Copilot 介面工作,就先比較同一工作上的輸出;若要接進自己的工具迴圈,模型之外還有工具、權限與停止條件,可接著讀 Agent Harness 的分工。
四、其他專用模型的雄心,不能共用同一張成績單
原文對 Cyber 2 Flash 使用 CyberGymE2E 的品質與單任務成本比較;對 Image 2.7 引用 Artificial Analysis 的影像編輯排名;對 Realtime 1 則描述即時語音評估與每音訊分鐘起價。三種說法各有不同分母:可重現漏洞、偏好評分、語音任務與計費分鐘,不能拼成「所有 AI 都同樣強、同樣便宜」。
尤其影像編輯與文生圖是兩種考題;語音起價也要配合輸入、輸出與實際使用的計費條件。本文沒有對這些模型進行 AlphaLab 實測,因此不替它們授予通用冠軍頭銜,也不以單一排名推斷資安防護或醫療轉錄的實際可靠度。原文列出的部署規模、錯誤率與客戶成效,應分別保留為微軟及其客戶的回報。
值得保留的核心,是微軟嘗試把不同能力的成本曲線往下壓;需要繼續驗證的,則是每一種任務在相同驗收條件下能省多少。評測的角色與資訊窗口會改變結論,Actor、Judge、Teacher 的判讀練習可以補上這個觀念。
五、Licensed Weights:掌控模型,仍有部署邊界
另一個關鍵是 MAI Licensed Weights 詳細公告。微軟描述的模式,是讓企業把 MAI 模型部署到自己的 Azure 環境,依專有知識調整,並控制存取、部署與升級時機。公告也表示,資料與調整成果保留給客戶,只有取得明確同意,微軟才會用來訓練自身模型。這些是方案承諾,具體權利仍需反映在交付與授權合約中。
截至 11 月 18 日,詳細公告的供應文字仍是 coming soon,透過 Frontier Company 合作提供,並引導聯絡微軟客戶團隊。應把它理解成已宣布、待方案接洽交付,而不是面向任何人的即時下載。官方描述的部署地點是 Azure;這份公告不足以支持「可任意搬到其他雲端」或「已取得開源授權」的結論。
權重是模型學到的數值參數,取得使用它們的授權,只回答了控制權的一部分。誰保存推論紀錄、誰能替換版本、調整後的模型能否匯出、合約結束如何移轉,仍是不同問題。這也讓「模型在我的環境」與「整套系統都由我營運」必須分開看;可對照 自架控制平面與推論邊界,理解不同層的責任。
六、AlphaLab 的判讀:專用能力值得試,總成本與退出路徑一起算
我同意:用常見任務換取更好的價格,是合理產品方向
許多日常請求有相似結構:看懂一段程式、修一個局部錯誤、依已知規則整理資料。若模型能把這些工作做好,並減少無效輸出,團隊就有機會把昂貴模型留給更難的少數任務。但「專用」只是設計方向,最終還是要以你自己的任務分布與合格標準驗收。
我存疑:漂亮的平均數,能否涵蓋少數昂貴失敗
一個跨檔重構若表面通過、卻破壞權限檢查,補救成本可能超過許多次便宜呼叫。比較模型時,應把功能測試、安全檢查、人工返工與等待都記進同一批任務;成功次數與失敗類型也要分開保存。Lovable 的資料權限案例說明,畫面正常與資料邊界正確,不能互相代替。
真正的張力:更深的客製化,可能同時提高價值與搬遷成本
企業資料越能改善模型,客製化就越有用;但資料整理、調校流程、評測集與部署工具若都綁在同一套服務,日後移轉也可能更費力。這是從方案結構推導的取捨,不是聲稱微軟已限制每一種匯出。評估 Licensed Weights 時,應把可攜權利、版本維持與結束合作後的處理方式列進採購問題。
微軟同時是模型供應者與產品通路,能把模型、工具和產品一起調整,這是一項實際優勢;它也讓內部評測更貼近自家場景。利益動機不能證明成績失真,但足以提醒我們:要拿到自己的任務資料,再決定能否外推。
七、下一步:先做一份雙價格、雙邊界的選型紀錄
挑一小批你有權使用、能回查對錯的程式工作,把現有模型與 MAI Code 2 放在相同工具權限、測試與截止條件下比較。每題保留輸出、錯誤、Token 與時間,最後分別用促銷價和標準價估算整批成本。這是建議的驗收設計,並非本文已完成的模型實驗。
再另外畫兩條邊界:第一條是資料去了哪裡,包括提示、權重、紀錄與備份;第二條是能帶走什麼,包括調整成果、評測集與部署設定。需要客製化的人,先取得可檢查的供應條件與合約,再投入訓練資料。這次發布值得注意的,是更多任務有了較便宜的候選;值得正式採用的理由,應是相同品質下省得下來,而且控制權說得清楚。
接著閱讀
左右滑動查看更多推薦
 內容類型:文章
MAI-Base-2 解析:微軟稱預訓練效率提升 4–12 倍,算力省到哪裡?(2026)
微軟完成 2.8T 參數底座預訓練,宣稱以更少 FLOPs 達到特定 BPB。拆解 4–12 倍的估算法、資料與硬體改進,以及為何不能直接換算產品能力或訓練帳單。
閱讀文章 內容類型:文章
MAI-Cyber-1-Flash 深度解讀:小模型最多接手九成任務,成本真減半?(2026)
Microsoft 用 MAI-Cyber-1-Flash 承接 MDASH 多數資安任務,最難部分才交給 GPT-5.4。本文查核 CyberGym 95.95%、80/90/95% 口徑與成本減半主張。
閱讀文章 內容類型:文章
Microsoft-Decision-1 發表:35 倍快在哪裡?Agent 決策評分解析(2026)
微軟把固定選項評分獨立成模型服務。拆開 35 倍延遲比較、校準排名與部署條件,判斷哪些 Agent 工作值得先試,以及何時應讓高分判斷停下。
閱讀文章 內容類型:文章
MAI-Transcribe-2-Streaming 登頂:語音 Agent 能邊聽邊做嗎?(2026)
Microsoft 發表 MAI-Transcribe-2-Streaming 與 MAI-Voice-2.1。Artificial Analysis 榜單確認轉錄優勢,但「部分逐字稿」的測試時點與語音 Agent 的即時行動不同。
閱讀文章 內容類型:文章
Microsoft MAI 行為準則:要把人類控制寫進模型,承諾還差哪一步?(2026)
Microsoft 公開 MAI 行為準則草案,承諾未來模型接受中斷、修正與關機,但現有 MAI 模型尚未用它訓練。本文拆解規則、同業脈絡,以及從宣言到可驗證控制仍缺的證據。
閱讀文章 內容類型:文章
Ox Alpha 真身揭曉:GLM-5.3-Flash 如何改寫開放模型成本線?(2026)
Z.ai 正式揭曉 Ox Alpha 就是 GLM-5.3-Flash。從 320B/18B 架構、MIT 權重、1M context、獨立評測到 API 與自架成本,本文拆解它改寫了什麼,又沒有改寫什麼。
閱讀文章