
2026 年 11 月 19 日,Apple 研究團隊在 arXiv 提交了〈Depth Pro 2: Sharp and Temporally Consistent Metric Monocular Depth〉。Depth Pro 2 想解決一個很具體的難題:照片裡的毛髮、羽毛與欄杆可以分得清楚,影片播起來時,這些細節的深度也能保持穩定嗎?
這份研究值得看的地方,是把距離尺度、物體邊緣與時間穩定性放回同一張考卷。下面先看團隊提出的機制,再拆開評測與速度的條件,最後討論這些證據足以支持哪些選擇。程式與權重已公開,但權重的研究用途限制也直接影響誰適合採用。
一、Depth Pro 2 的核心:一張清楚,還要每一幀都說得通
單目深度估計,是從普通相機的影像推估每個像素的深度。相對深度回答「誰在前、誰在後」;公尺尺度的深度還要回答大約隔多遠。依 官方輸出說明,這裡的 depth 是沿相機觀看方向的 Z 座標,並非每個點到相機的直線距離。彩色深度圖則只是把數值映射成顏色,方便眼睛檢查。
想像替一隻毛茸茸的動物加背景散景。深度邊緣太模糊,毛髮旁會混進背景;每張都清楚、但前後幀估出的距離飄動,散景又可能忽強忽弱。靜態截圖漂亮與整段影片可用,回答的是兩個問題。這正是原文開場案例要說的事。
processes both images and video and predicts depth maps at native resolution.
中文:同時處理影像與影片,並在輸入的原生解析度預測深度圖。
Apple 研究團隊,Depth Pro 2 論文摘要節錄
這個方向有前史。Apple 的 第一代 Depth Pro(2024 年 10 月)已主打銳利邊界與公尺尺度;另一條 Video Depth Anything 路線把長影片的一致性放在中心。Depth Anything 3 也已研究以多張輸入恢復一致幾何。這些前作支持的是問題與方法脈絡,並不能獨立替 Depth Pro 2 的新成績背書。
二、它怎麼同時顧細節與穩定?讓影格交換資訊,也保留解析度
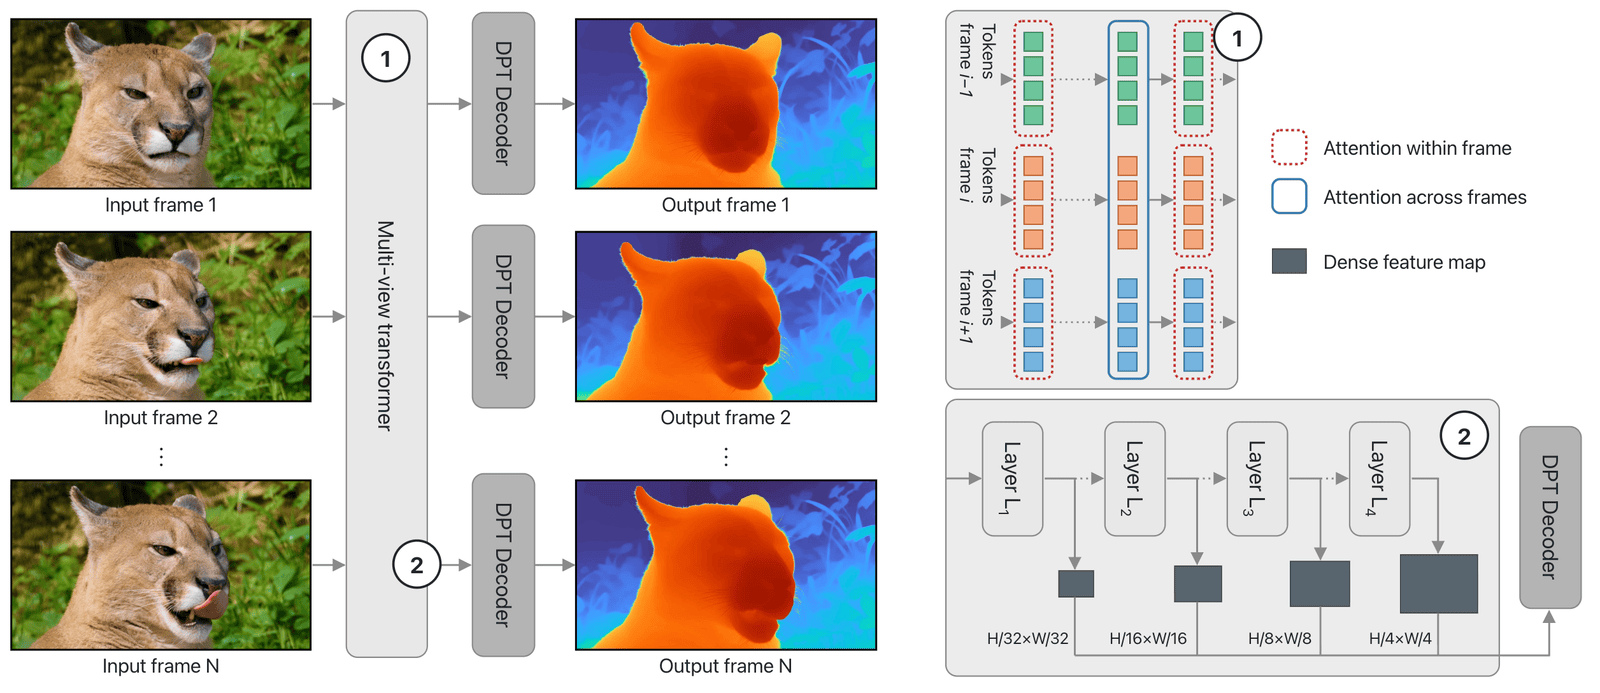
依原文方法章,深度網路以 DINOv3 視覺骨幹初始化;前段先處理各張影格自己的資訊,後段交替進行影格內與影格間注意力。白話說,模型先認清每張圖,再讓鄰近畫面互相提供線索,最後由 DPT 解碼器輸出每幀的逆深度。單張照片可視為只有一幀的片段。
穩定性也進入訓練目標。團隊用相機姿態,把某幀看到的點投影到另一幀,懲罰互相不一致的深度;遇到遮擋或移動物體,則利用真值資訊排除不符合靜態假設的點。這讓「不要亂跳」有明確的學習訊號,而不是只在輸出後把影像抹平。
細節則連著資料製程。作者表示訓練混合 19 個資料集,包含內部真實與合成資料,並避免插值深度真值,以免把物體交界平均成原本不存在的中間距離。這是合理的工程動機;不過完整訓練資料含內部部分,公開推論入口不能直接等同於完整訓練可重建。
還有一個容易被「單一網路」蓋過的零件:公尺尺度仍需要焦距。已知焦距可直接提供;未知時則另用視角估計器。官方文件指出,焦距多估 10%,整體深度尺度也會多估 10%。因此影片使用共同焦距的假設,應列入變焦素材的驗收,而不能只檢查彩色輪廓是否好看。
三、Depth Pro 2 的成績:平均領先,要和每一道考題分開讀
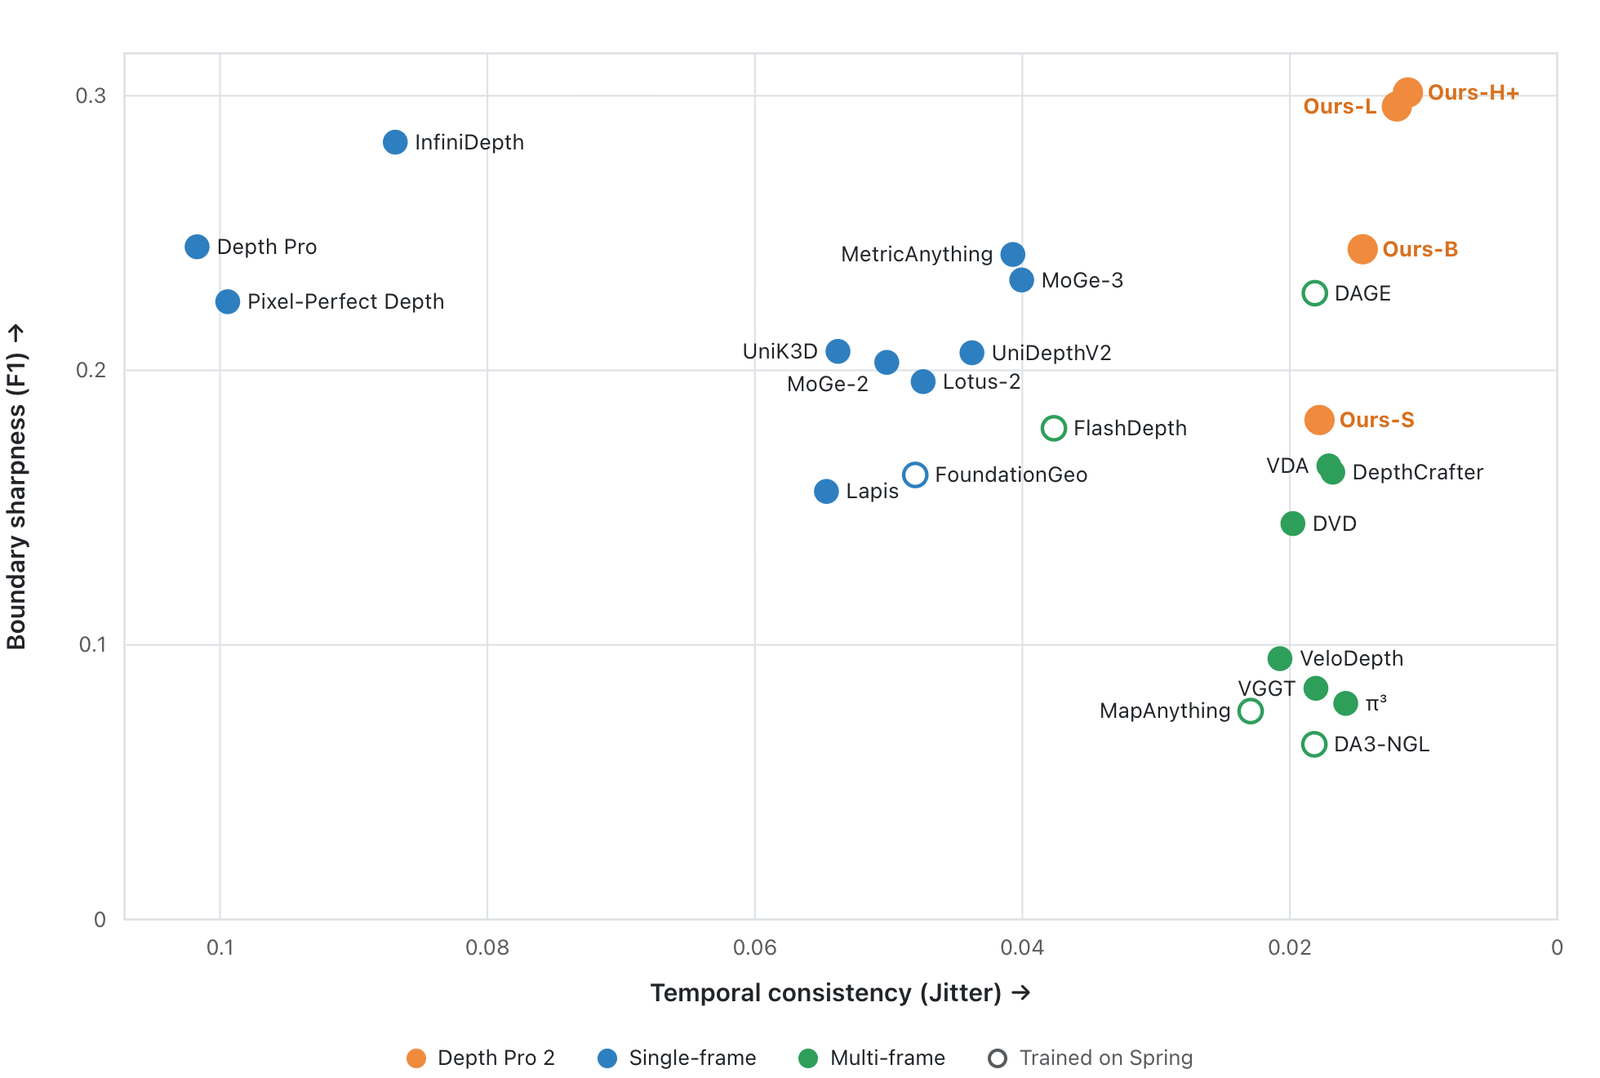
官方主圖把兩個品質指標排在一起:Boundary F1 衡量深度邊界,Jitter 衡量沿點軌跡的深度誤差如何隨時間改變。圖上的橘點顯示作者回報的模型家族取捨:較大模型通常更清楚、更穩定。這張圖的資料範圍是 Sintel 與 Spring,並非所有真實拍攝影片。
論文另以單張與影片兩種設定評估公尺尺度準確度,分別測已知及預測相機內參。主表採 δ1,也就是預測深度落在真值的 0.8 到 1.25 倍之間的像素比例,愈高愈好;再回報跨資料集平均名次。這種拆法比只挑一支漂亮展示影片有用;讀者可以看出同一模型在不同考題的表現。但平均名次把每個資料集化成排序,不能直接解讀為平均距離誤差改善了幾成。
更關鍵的是,原文自己的表格就能反駁「每一項都第一」這種讀法。表 4 的單張 Sintel 邊界分數,InfiniDepth 是 44.8,Depth Pro 2-H+ 是 40.2,這裡愈高愈好;表 5 的 Spring Jitter(表中為原值乘以 100),VeloDepth 為 0.72,H+ 為 0.86,這裡愈低愈好。這些都是 Apple 重測基線後的同表比較,足以限制全勝敘述,仍不是第三方對新模型的獨立重現。
換一把尺,排序也可能改變。附錄表 8 改用平均相對絕對誤差 AbsRel,單張影像、預測內參設定下,H+ 的平均名次是 3.9,UniK3D-L 是 3.3,較低較好。因此「準確度領先」必須連著使用哪個指標說,不能概括成任何誤差定義都領先。
評測設定也要一起保留。附錄 F.3說明,邊界與相對深度使用逐幀尺度、位移對齊,時間指標則使用整段影片一次對齊;準確度比較保留各方法官方推論解析度。這能觀察既有方法交付出的品質,卻不能把差距全歸因於某個注意力設計。對齊後的結構好,也不等於未校正的公尺值同樣準。
社群已出現非官方 ONNX/TensorRT 移植與速度回報;該專案的轉換誤差對照的是原版 PyTorch 輸出,並非場景真值,解析度與推論後端也和論文不同,不能直接確認上述品質排名。截至 2026 年 11 月 21 日,本次檢索未找到針對論文品質評測、足以採用的獨立重現報告。因此本文保留「作者回報」的歸屬,不把新聞轉述算成第二份實驗。
四、53 FPS 是哪一種快?B200、串流模式與焦距估計一起看
原文的亮點包括:最小 S 模型約 2,430 萬參數,最大 H+ 約 8.72 億參數。這兩個數字是深度模型本身,表 1 排除另行共用、約 2,350 萬參數的焦距估計器。官方下載頁另列 B、L 兩個中間尺寸,讓使用者在品質與資源間選擇。
論文介紹的 1080p 無緩衝串流(unbuffered,時間視窗 C=16)速度,S 約 53 FPS、H+ 約 8 FPS,測試硬體是單張 B200。附錄 F.5 的計時規則更寫明:焦距已給定,該組測試排除視角估計網路,以 PyTorch eager 模式、暖機後計時。不能把這組數字當成任意電腦、含解碼與所有處理的即時影片速度。
同一篇論文附錄 B.4 的表 13 又列出另一套測試:32 幀一起處理,計入焦距估計;1080p 下 S 為 44.8 FPS、H+ 為 5.3 FPS。兩套數字回答不同配置的問題。比較快慢前,至少要對齊模型、解析度、時間視窗、是否含焦距估計,以及量的是吞吐量還是收到一幀到交出結果的等待。
官方推論有兩種模式:buffered 先累積一小段影片,預設 16 幀、相鄰片段重疊 4 幀;unbuffered 則逐幀處理並保留過去影格資訊。前者要把等片段湊齊的時間算進去,後者要考慮快取與即時輸入的負荷。縮小解析度可能省資源,也可能犧牲你原本想保住的細節。
五、能下載之後,距離可採用還隔著授權與驗收
本次核對 官方程式庫與 模型頁,程式與權重已有公開入口。官方 README 同時明列,程式庫包含推論程式,不包含訓練或評估程式。因此研究者可以從公開權重開始比較,但完整重建論文評分流程仍需額外工作。
權重適用的 Apple Machine Learning Research Model 授權把用途限定為非商業科學研究與學術開發,並明確排除商業利用、產品開發,以及商業產品或服務中的使用。公開權重不能直接推導成可以放進收費剪輯服務。有商業導入需求時,這個條件應在投入整合之前先解決。
對符合授權的研究工作,官方程式已提供公尺深度、焦距與視覺化輸出。檢查實際數值時,要分清原始深度與為觀看而調色的 PNG/MP4;看起來相近的顏色,不是可跨影片直接比較的尺。本文以公開研究與文件為依據,沒有把作者展示改稱為 AlphaLab 本機實測。
六、AlphaLab 的判讀:清楚與穩定值得一起進步,採用標準也要一起升級
我同意:把時間與細節放回同一張考卷
對散景與合成,真正有價值的改進是輪廓保得住、下一幀也不亂跳。原文把這個衝突拆成可測量的目標,並提供模型尺寸選擇,研究價值比一句「AI 看懂 3D」更具體。它也提醒我們:把所有結果平滑化可以讓畫面穩,卻可能把細節一起擦掉,品質必須同時驗兩邊。
我存疑:一張平均成績圖,能替多少素材簽收?
作者自己的表格已有輸贏交錯,解析度、焦距來源與對齊方式也會改變答案。比較成熟的結論是:這是一條值得研究的整合路線;若要宣稱自己的影片工作流更好,仍需把鏡頭變焦、遮擋、細線條與跨片段接縫放進同一組素材,再檢查最終效果。
下一份有用的證據:從深度圖走到實際成片
附錄 D 把不同深度估計接到固定的散景渲染器,提供 220 個單張場景的定量比較,也用一支 197 幀手持影片作定性展示。這比只比色圖更接近使用目的;但單張量化與單支影片展示,仍不能代替多種長影片的獨立量化驗證。新視角展示也應視為指定場景與渲染流程下的結果。可以對照 SplatAnything 的 3D 重建分析:中間表徵進步與最後作品改善,需要分別留下證據。
七、現在怎麼判斷:先拿一段會讓方法出錯的素材
研究者可以先選一段同時包含細毛、移動前景與背景遮擋的短片;固定鏡頭與焦距設定,再各自保存深度數值、邊界近照與最終散景影片。接著比較不同模型與模式,記錄硬體、解析度、視窗及完整處理時間。目標是找出錯在哪裡,而不是替平均排名找一段最好看的例子。
如果你主要想做出作品,可先讀 InfiniSplat v2 的照片轉 3D 場景教學,認清深度圖、場景表示與相機移動的差別。Depth Pro 2 這次最值得留下的問題是:當你把影片播完,細節、尺度與穩定性,是否仍同時成立?
接著閱讀
左右滑動查看更多推薦


