
2026 年 11 月 18 日,新加坡國立大學的 Yuhe Liu、Qi Li、Shihua Zhang 與 Xinchao Wang 在 arXiv 提交了〈Jeveration: System One Models Now Generate〉。這篇 Jeveration 論文追問的是:如果模型一次同時選好整張圖的代碼,各個位置怎麼知道自己正在畫同一個世界?
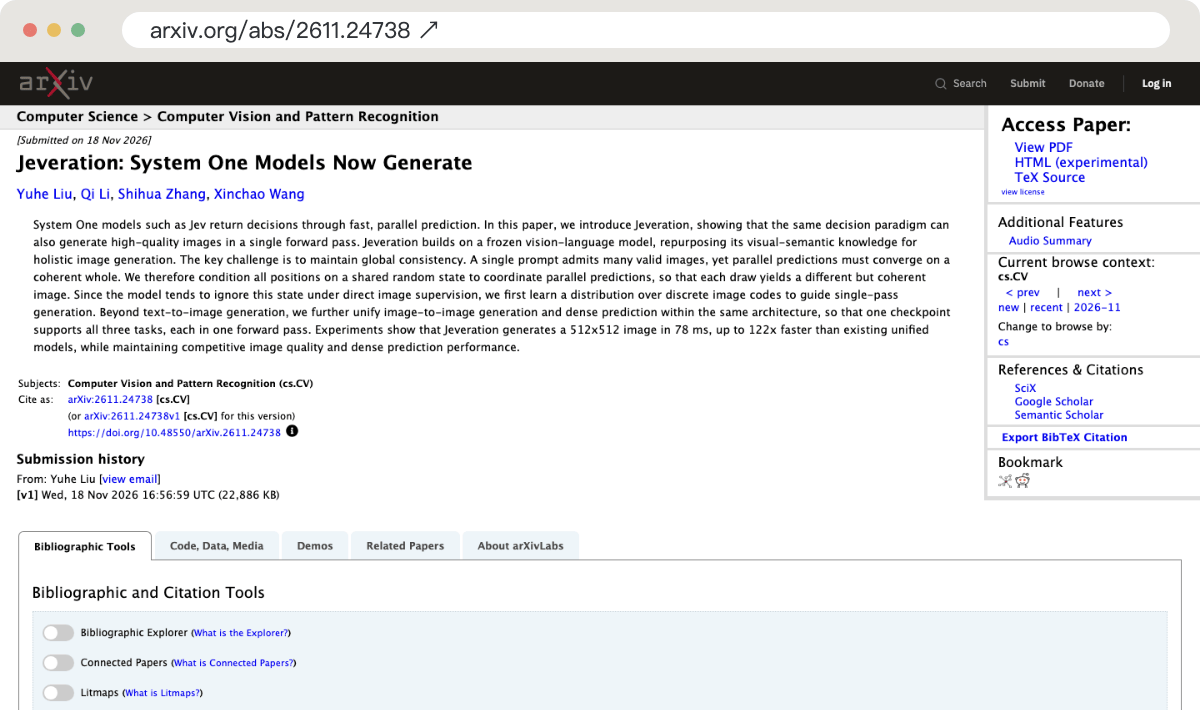
論文最吸睛的數字是 78 毫秒與最高約 122 倍加速。但比速度更值得讀的,是作者如何處理平行決策的協調問題,以及哪些工作被移到訓練階段。以下先讀懂機制,再對照實驗,最後判斷這種路線何時值得採用。
一、Jeveration 論文的核心:同時決定,還得決定同一張圖
The key challenge is to maintain global consistency.
中文:關鍵挑戰是維持全局一致性。
Jeveration 論文摘要
想像請幾位畫家同時畫一隻貓:有人選白貓,有人選黑貓;有人畫正面,有人畫側面。每個局部單看都合理,拼在一起卻不是同一隻貓。這是平行生成容易遇到的問題:提示詞描述一群可能的答案,沒有替每個位置指定唯一的完整構圖。
依原文方法章節,Jeveration 為一張影像抽取一份共享隨機狀態,讓各個代碼位置都以它為條件。你可以把它理解成全體先拿到同一份構圖草案,再各自作答。這份狀態每次可變,因此保留多樣性;同一張圖內又共享,讓局部選擇有共同依據。這是對方法的比喻,並非系統真的先產生一張可見草圖。

數學上的重點是條件不同:固定提示詞就獨立抽樣,會漏掉位置之間的相依;加入共同狀態後,再對不同狀態混合,便可以表達跨位置關聯。不過,「可以表達」與「已經學好」是兩件事。模型若忽略共同狀態,額外加一份亂數也不會自動讓貓的身體對上頭。
二、一次前向的背後,是兩階段訓練與額外解碼
作者先訓練遮罩預測:隱藏部分影像代碼,要求模型根據可見部分補回,學習什麼組合會出現在同一張圖。第二階段再用這個參考分布,引導從隨機狀態出發的單次決策;輔助模型追蹤目前生成分布,兩者的預測差異提供訓練訊號。最後還加入低信心位置的修正目標。
這些教師、輔助模型與多輪修正用在訓練,不能把它們算成每次生成都要重跑的步驟。同樣地,也不能把推論一次前向讀成整個流程只有一次矩陣運算:模型先平行決定 128 個影像代碼,還要由解碼器轉成可見像素。

這裡的「凍結」也要讀準。論文採用 Qwen3.5-4B 作為凍結骨幹,新增共享 LoRA 適配器和輸出模組;補充材料列出約 10 億個可訓練參數。它重用既有視覺語意能力,並非把現成聊天模型切一個設定就能出圖。對研究者而言,價值在於用什麼訓練方式把既有表示轉成視覺輸出。
作者官方儲存庫已提供推論程式,並連向權重與示範。因此,把它寫成只有論文、尚無程式,已不符合本次查閱狀態。這也不等於 AlphaLab 已重現成績:本次未下載模型或執行 GPU 生成,以下速度與評分均歸屬作者實驗。
三、78 毫秒與 122 倍:先把比較的分母放回來
論文 Table 1列出下列結果。計時使用同一張 NVIDIA H200、batch 1,涵蓋提示到解碼影像;補充材料說明先暖機兩次,再取五次呼叫的中位數。這使表內延遲比較有明確條件,但仍是暖機後的小樣本測試。
| 模型 | 輸出解析度 | 延遲 | GenEval |
|---|---|---|---|
| Jeveration | 512 × 512 | 77.8 ms | 0.74 |
| Show-o Turbo-512 | 512 × 512 | 94.1 ms | 0.63 |
| Janus-Pro-7B | 384 × 384 | 9,508.4 ms | 0.80 |
9,508.4 ÷ 77.8 ≈ 122.2,對應 Janus-Pro-7B;這個基準同時有不同解析度,且是表中最慢的一列。換成同為 512 像素的 Show-o Turbo,94.1 ÷ 77.8 ≈ 1.21,延遲約減少 17.3%。這仍有進步,卻是很不一樣的幅度。後者也不是只改生成步數的控制實驗,不能把全部差異都歸功於單次決策。
另外,Jeveration 的 GenEval 低於表內 Janus-Pro-7B。這個例子本身就提醒我們:速度較快,沒有自動附贈品質全面領先。表格適合用來定位取捨,不適合濃縮成「比現有模型全部快 122 倍,而且品質一樣」。
依 GenEval 原作者的評測說明,它主要檢查物件共現、位置、數量與顏色等組合屬性。因此,0.74 不能翻譯成「74% 的商業設計可交付」,也不能替代美感、中文字形、品牌一致性或編修精度的逐項驗收。讀模型成績時,這和綜合評分與實際工作能力分開看是相同原則。
四、真正的新意在哪裡?單步生成有前史,多任務也有代價
把單步生成當成這篇論文才出現的概念,會讀錯歷史。2023 年的 Consistency Models就明確研究一步生成,也保留用更多步數換品質的途徑。Jeveration 值得追的是另一個結合:在凍結視覺語言骨幹上,用共享隨機狀態協調平行影像決策,並讓同一份 checkpoint 支援多種視覺輸出。
生成圖片、依輸入圖片轉換、為每個位置預測分割/深度/法向量,雖然都產生視覺輸出,成功條件並不相同。生成容許多個合理答案;深度圖則要對應眼前場景的幾何。共用骨幹是否划算,必須在各任務上分別看。
原文密集預測對照裡,Jeveration 的分割 mIoU 為 67.7,接近同骨幹單任務模型的 67.8;但深度絕對誤差為 0.267 公尺,單任務對照為 0.246,法向量平均誤差則為 24.2 度對 21.2 度,這兩項都是越低越好。合理讀法是整合有成果,也存在任務取捨;不是整合後每項都無損。
作者的組件消融也應留在各自分組內比較。固定/隨機狀態、修正目標、輸出頭的實驗,並非全部從同一個基準出發。它們支持某個設計在該設定有用,還不足以把每個分數增益相加,或直接推成所有提示詞上的因果解釋。想練習分清研究結論的適用範圍,可以接著讀K2-Horizon 的控制證據解讀。
五、AlphaLab 的判讀:把協調學進模型,仍要把品質留在驗收裡
我同意的部分:少等下一步,是有價值的架構方向
當整張圖的代碼可以一起決定,就能減少必須等待前一步完成的生成鏈。這特別吸引需要快速預覽的場景:先看構圖,再改描述,讓人與工具保持對話節奏。我的判斷是,這類方法值得以「可互動的視覺草稿」為起點評估;這是應用推論,並非論文已測出使用者生產力。
共享亂數的意義,則是讓多樣性與一致性有共同設計入口。它不是把隨機性消掉,而是要求不同位置對同一次抽樣作出相容回應。往後若能在更複雜構圖中持續成立,這會比單一漂亮樣本更有說服力。
我存疑的部分:快一張,未必更快拿到能用的一張
假設方法 A 每次更快,卻需要多抽幾次才得到正確的左右位置、數量和文字,真正應比較的是到第一張合格成品的總時間。還要算載入、排隊、條件處理、篩選與重做。暖機後五次呼叫的中位數能回答核心推論延遲,回答不了這整段工作。
這不是要求研究論文一次完成產品驗證,而是把採用問題問得更準。若你在意的是畫面可交付,就像VibePrevisBench 的場景與畫面雙重驗收,應先寫出「對」的條件,再看每個生成流程如何到達。
最值得追蹤的下一份證據:固定考題與失敗樣本
Jeveration 論文提供了具體架構、對照與可檢查的實作入口;對「每次生成都可又快又好」這種更大的承諾,仍應要求固定考題、完整輸出與不同硬體上的量測。本次找到的公開材料不足以讓 AlphaLab 把作者數字升格為獨立重現結果。
最能改變我判斷的,會是同一批複雜提示詞、相同解析度、相同合格標準下的比較:保留所有抽樣,報告成功率、每張合格圖的耗時與記憶體占用,再看多任務版本犧牲了哪些細節。若這些條件下仍有穩定優勢,採用理由就比「單步」這個標籤更扎實。
六、現在怎麼做:先定義你要哪一種快
一般創作者可先從官方專案頁看樣本與機制,挑出自己在意的內容、數量、空間關係和風格控制;不要由展示圖推算成功率。有現成 CUDA 測試環境的開發者,再評估官方推論程式及其依賴模型。權重公開只提供測試入口,不替你的部署授權、資源需求與輸出品質完成驗收。
官方權重頁的範圍說明將影像列為 512 × 512,提示與指令為英文;密集預測訓練來自 NYUv2 室內場景。若你的目標是繁中提示、任意照片編輯或戶外幾何,應各自設題驗收,不要由同一份 checkpoint 支援三類任務,就推定已涵蓋每種需求。
測試時把問題分成兩欄:一欄是「一次出圖等多久」,另一欄是「幾次才拿到合格圖」。固定提示詞、seed 清單、模型版本、解析度與硬體,冷啟動和暖機分列,失敗照樣保留。不要為了驗證一個漂亮數字,臨時擴大硬體或資料下載;先在已有資源上確認是否值得繼續。
研究路線的啟發是:把原本要在推論時逐步解決的協調,盡量提前學進模型。使用者的採用準則則應落在結果:更短的生成鏈,能否在相同品質門檻下,縮短拿到合格影像的時間? 這也呼應首跑等待與後續生成分開量測、以及成本分母走到合格交付的做法。
接著閱讀
左右滑動查看更多推薦
 內容類型:文章
OpenAI 晶片設計進展:AMD 最高 14% PPA 改善,驗證走到哪一層?(2026)
OpenAI 回報模型參與 AMD 與 Jalapeño 電路最佳化。拆開區塊 PPA、送交製造與 RISC-V 評測,判斷哪些進展值得重視、哪些仍需要下一層驗收。
閱讀文章 內容類型:文章
Gemini 4 Neon 發布:更快卻未必更省,先看 Carbon 折扣與思考檔位(2026)
Google 推出 Gemini 4 Neon,獨立評測的品質進步有限、完成時間卻縮短。對照 Carbon 的 11 月折扣與 12 月標準價,再看 high、xhigh 的任務差異,判斷何時值得換用。
閱讀文章 內容類型:文章
【2026 最新】inside-llm 教學:怎麼找出 GGUF 第一個分歧 Token?六步分清量化與抽樣
同一句問題換了量化就答不同,差異從哪一步開始?用 inside-llm 的候選分布、抽樣關卡與錄製回放,把量化、抽樣和後續前文分開查。
閱讀文章 內容類型:文章
Microsoft MAI Code 2 發布:98% 表現、四成成本,授權權重又能掌控什麼?(2026)
微軟在 Ignite 推出新一代 MAI 專用模型。拆開 Code 2 的四項評測、五折促銷與供應入口,再看 Licensed Weights 的 Azure 部署與控制邊界,判斷哪些證據足以支持選型。
閱讀文章 內容類型:文章
Hy4 flash 發布:低價百萬上下文模型,真的讓 Agent 交付更便宜嗎?(2026)
騰訊推出 Hy4 flash,把低 Token 單價、較短輸出與日常任務評測放在同一張帳單。對照 Vercel 上架與現行費率,分清可驗證的供應、內部盲測與每件合格成果的真正成本。
閱讀文章 內容類型:文章
Antigravity /teamwork 研究解讀:AI 能解難題,誰來驗收答案?(2026)
Google 公布多 Agent 數學與工程成果。從 Courtade–Kumar 的公開 Lean 證明,到 Rust 解碼器 20–30% 加速回報,分清研究產物、公司數字與可重建證據。
閱讀文章