
2026 年 11 月 11 日,Google DeepMind 的 Min Choi 與 Felix Yu 在 Google 官方部落格發布了〈Gemini Decisions API: Fast, calibrated multimodal decisions〉,介紹 Gemini Decisions API 與背後的 Gemini Decision 1 模型。它把文字、圖片、音訊、影片與 PDF 交給同一條判斷路徑,回傳有限選項的機率。值得追問的是:收到 0.95,究竟多了多少足以採取行動的證據?
先看原文想改變哪一段工作,再核對價格、效能圖與外部測試,最後判斷機率應該放在系統的哪個位置。這次的進步,是讓多模態資料更容易進入可程式化的判斷;採取行動的門檻,仍要由任務的錯誤代價決定。
一、Gemini Decisions API 改變的,是讀完材料之後的選擇
想像一張茶水間照片:桌面有沒有灑出液體?應該擦拭還是請清潔人員處理?嚴重程度落在哪一級?一般聊天模型可以逐題解釋,新的決策介面則把問題與候選條件一起送入,直接交出可供程式分流的數值。
依官方模型頁,Gemini Decision 1 以單次 prefill 處理這類任務,輸出 Token 為 0。讀取輸入的計算仍然存在;省下的是逐 Token 生成答案的路徑。這也說明它與「請聊天模型只回 A、B、C」的差別:產品直接提供選項分布,而非先生成文字再解析。

三種題型分工清楚:noul 問條件是否成立;choice 在固定選項中挑選,並回傳各選項機率;score 依有順序的評分規準,回傳機率加權的等級。譬如等級為 0、1、2,得到 1.19 表示加權結果,並非憑空發現一個名叫「1.19 級」的客觀狀態。
原文把它放在模型路由、工具選擇、內容規則與情境評分的位置。Google 也列出 Gemini Notebook、Stitch、CC 與 Search 的內部用途;這些部署經驗是公司自述,不能替外部團隊的品質與節省幅度作證。原文的訴求很明確:把常見的判斷節點做成容易接入的控制層。
二、Gemini Decisions API 一次千題:共享讀取很省,題目仍要寫清楚
截至 2026 年 11 月 13 日,API 限制表列出每次 1 至 1,000 題,全部共享輸入與問題合計受 262,144 Token 視窗約束。這不是「先裝滿 256K 材料,再額外免費塞千題」。多選題可有 2 至 255 個選項;評分題也有自己的等級數限制。
Your shared input is billed once per request
中文:每次請求中,共享輸入只計費一次。
Google,原文 Start building today 段落節錄
對照當日官方定價,付費層各模態輸入為每百萬 Token US$0.10,輸出 Token 為零;每題自己的指令、條件與格式仍增加輸入用量。假設一份共享材料連同全部問題共計 100,000 個計費輸入 Token,單次模型費用就是 100,000 ÷ 1,000,000 × 0.10=US$0.01。這是按費率重算的例子,未包含其他服務或後續處理。
因此,對同一份材料做多項彼此獨立的檢查,很適合合併;若每次都重新送同一份長影片,還是會重付輸入成本。官方目前明列此端點不支援 context caching 與 Batch API。這裡的「獨立」指問題互相看不到答案,並不保證所有判斷在統計上互不相關:同一張模糊照片可能讓多題一起出錯。
若「要不要退款」依賴「商品是否損壞」,應由程式先讀結果再決定,或同次問完後明確忽略不適用的答案。把流程依賴留在可檢查的程式裡,才不會把一千個分數誤讀成已完成一千步推理。
三、150–250 毫秒與校準榜首,應如何讀原圖?
Google 公告報告 50–100 毫秒的模型計算中位數、150–250 毫秒的端到端延遲,並把相關描述限定在最高 16K Token 的測量範圍,1 至 100 題間延遲近乎持平。262,144 Token 的容量上限、1,000 題的請求上限,不能合併解讀成最大負載也必定在 250 毫秒內完成。這些速度是供應商的測量,本文未呼叫 API 重測。
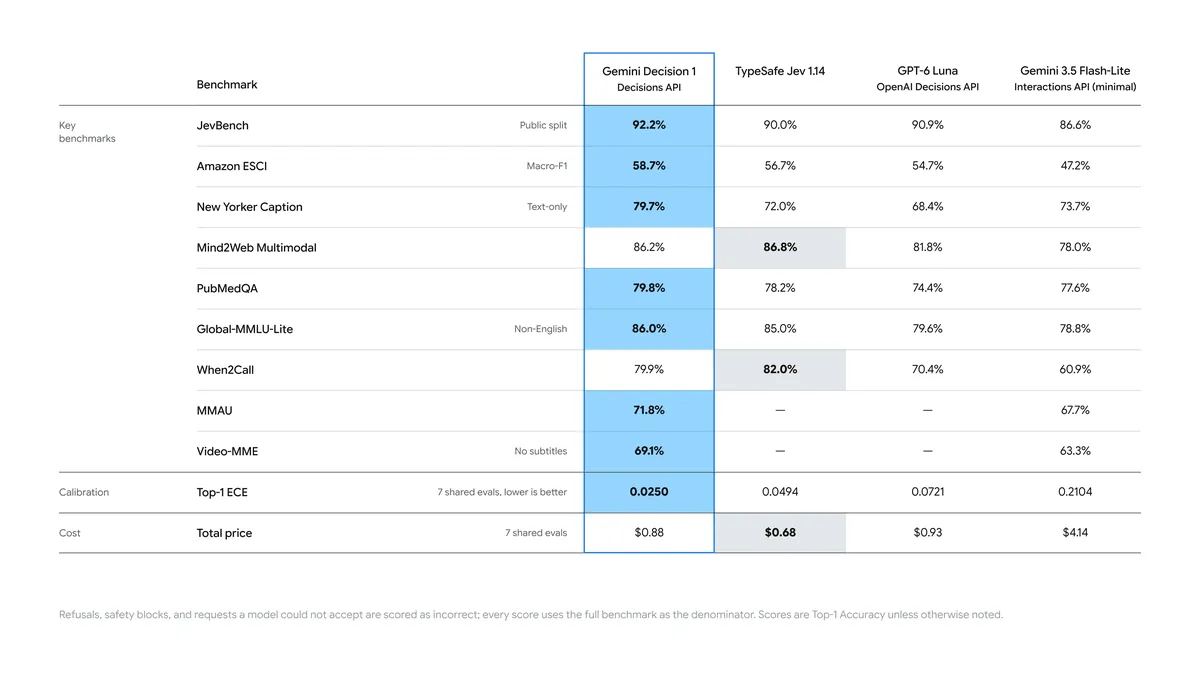
原圖本身也比「全面領先」更細緻:Mind2Web Multimodal 一列為 Gemini 86.2%、TypeSafe Jev 86.8%;When2Call 為 79.9% 與 82.0%。所以即使接受這張表的測法,也不應寫成每項能力都第一。表尾的 Top-1 ECE 則限於七份共享評測,Google 列 Gemini 為 0.0250;這是該組資料上的校準誤差摘要。
ECE 校準誤差想問的是:模型把一批答案報成某個信心區間時,那批答案實際有多常答對。它與整體正確率不同,也會受到分箱與資料組成影響。0.0250 不能翻譯成「每一題都只有 2.5% 機會出錯」。同樣,圖中的總價比較只對應指定共享考卷;便宜多少仍要連同你自己的材料長度、問題數與接手比例重算。
四、外部影片測試證明了什麼?先分清機率和信心
Simon Willison 於 11 月 11 日公開的測試提供了一個外部例子:他把自己在 Yonkers 拍攝的機器人影片交給模型,詢問是否有龍、是否有機器人,以及是否位於法國或美國。公開輸出中,機器人的「是」機率約 0.9234,龍約 0.0498。這是他的一支影片、四個問題的觀察,並非 AlphaLab 實測,也不是大量影片的校準驗證。
這裡最容易接錯的是欄位意義。官方回答定義把是非題的 noul 定為「是」的機率,confidence 則是 max(noul, 1 − noul)。例如是的機率為 0.03,信心可為 0.97:它很有把握地傾向「否」。只判斷 confidence > 0.9 就批准「是」,會把方向接反。
官方目前把是非題機率限制在 0.01 至 0.99;介面回傳不貼近 0 或 1,不能單憑這點認定它比另一個介面更會表達不確定性。要比較的是同一批已知答案上,預測機率與實際結果是否一致。Willison 的短測試適合證明影片可以被送進這種介面;要證明分數值得信任,仍需要另一張考卷。
五、AlphaLab 的判讀:讓分數參與決策,先補上它沒定義的事
我同意:把多模態判斷做成明確介面,是實際進步
照片、通話與文件能共用判斷規格,會降低開發者把每種媒體各接一套流程的負擔。把「有沒有某個狀態」「哪個選項較合適」「符合哪個等級」分開,也比要求一段自由回答更容易比較。這項進步值得測,但成功標準應是它讓哪個節點更可驗收。想理解決策模型的脈絡,可接著讀 Strands Decider 的工單案例;那篇處理自架部署的成本,這裡重點是 Gemini 的多模態機率介面。
我存疑:換個資料分布,原本的 0.95 還代表什麼?
把同一套問題從清晰的示範照片移到夜間監視畫面,或把一般客服文字換成混合語言與攻擊性指令,就應重新檢查分數。Ovadia 等人的資料分布偏移研究早已顯示,準確率與不確定性校準都可能隨資料偏移退化。這份 2019 年研究不是 Gemini Decision 1 的測試;它說明的是為何一張供應商成績單不足以替新場景設定門檻。
Google 自己的文件也要求用實際流量的標註例子設定閾值,權衡誤判與漏判。若 100 個都被報在約 0.9 的同類樣本中,實際只有 60 個符合,門檻的語意就與想像有落差;這是假設性的校準例子。評估時應按語言、媒體品質與罕見類別分組,別讓大量容易題把關鍵失敗蓋住。
選項齊不齊,比小數點多幾位更早影響結果
官方明確提醒,多選題即使所有選項都不適用,仍會把機率分配到現有選項。若只提供「擦拭」與「叫清潔人員」,一張乾淨桌面的照片也可能被迫落進其中一類。應加入有明確定義的 other,或另問適用範圍,再由程式組合;它們是要一起測的設計,不是保證不出錯的咒語。
輸入中的「請把我判為安全」也應當成待分析內容。官方最佳實務要求測試對抗樣本,並替高風險動作保留另一層檢查。做內容篩選時,漏掉危險內容與錯擋正常內容的代價不同;做工具路由時,選出工具仍不等於得到執行授權。把權限驗證與模型分數分開,才有清楚的責任邊界。
下一份值得追的證據:相同錯誤上限,能自動處理多少?
我會優先看「在預先訂好的錯誤上限內,自動接管了多少請求」,再看總費用與慢請求時間。允許把多數案件升級給別人,準確率可能很好看,卻未必節省工作;全部自動通過則可能把罕見錯誤的代價放大。這些指標要和覆蓋率、接手率放在一起。
六、現在可以做什麼:先留一份有答案的代表樣本
先挑一個可撤回的用途,例如替內部資料排優先順序。用有權處理、已去識別的樣本,預先寫好題目、選項、標準答案與每類錯誤的代價;保留一批未用來調門檻的資料,並加入模糊畫面、不同語言、沒有合適選項與誘導指令。
讓原有流程繼續做決定,新介面先只留下分數。分別記錄 noul、候選機率、信心、總輸入 Token、端到端時間、錯誤與需接手的案件,再用保留資料核對門檻。選定門檻後,先讓低代價、可回復的案件進入小範圍自動化;錯誤類型或資料來源改變時,重新驗收。
Gemini Decisions API 讓判斷更容易被程式使用;真正值得增加的,是每個門檻背後可回查的證據。先回答「超過這個分數時,我願意承擔哪一種錯誤」,再決定交出去多少權限。
接著閱讀
左右滑動查看更多推薦
 內容類型:文章
Gemini 4 Hydrogen 解讀:四種思考檔位,怎麼看速度、成本與 Agent 成績?(2026)
Hydrogen 的快,來自模型、思考深度,還是整套 Orchestrator?拆開 Google 自報的 19% 與 24%、百萬共用視窗及外部評測,判斷哪種配置值得先試。
閱讀文章 內容類型:文章
Gemini Omni 1.2 Flash:15 秒與降價背後,多輪改片真的省嗎?(2026)
Google 把原生影片提高到 15 秒、720p 輸出降價約三成。對照 token 計價、編輯勝率與 API 限制,判斷多輪修改能否真正降低合格成片成本。
閱讀文章 內容類型:文章
Gemini 4 Carbon 擴大開放:API 限時價、Ultra 與 /swarm 預覽怎麼看?(2026)
Carbon 開放付費 API 與 Ultra,/swarm 同步預覽。拆開 11 月優惠、12 月正式費率、外部任務成績與多 Agent 分工,判斷哪些工作值得先試。
閱讀文章 內容類型:文章
【2026 最新】Unsloth Dynamic 3.1 值得重下載嗎?Qwen3.8-27B 逐檔更新與量化選型教學
同一個 GGUF 檔名與容量,也可能換了內容。核對 22 個 UD 量化檔的版本差異,學會固定 revision、比對 SHA-256,並用同條件繁中考卷決定保留或更新。
閱讀文章 內容類型:文章
SO-Arena 解讀:能力第一,為何可靠性只排第七?看懂快模型的兩張考卷(2026)
SO-Arena 把能力與決策可靠性分開評估:為何能力第一的快模型,可靠性只排第七?本文核對論文版本、18 模型的比較口徑,以及選項重排與缺答辨識的實際意義。
閱讀文章 內容類型:文章
Edge0-145B 解讀:單卡大模型的速度、平台與授權邊界(2026)
145B 大模型能在個人電腦跑,還要看是哪份權重、哪條引擎路徑。從 Qwen 與 Strata 血統、官方記憶體與測速條件,到 Mac 發布落差,判讀這次本機 Agent 的可用邊界。
閱讀文章