
2026 年 11 月 11 日,Lichen Li、Ziping Dong 等五位作者在 arXiv 發布了 〈SO-Arena〉預印本,提出一份同時衡量快模型能力與決策可靠性的考卷。SO-Arena 最值得追問的,是模型答對很多題之後,換一下選項,它的判斷還靠得住嗎?
先看作者如何設計兩張考卷,再核對「第一名變第七名」的分母,最後想清楚這會改變哪一種選模判斷。以下固定在論文 v1 的結果;本文核對公開論文、程式說明與數值,未執行模型推論。
一、SO-Arena 的問題:選得快,也要知道何時不該選
想像一個客服分流員:客人問退款,桌上有「退貨、付款、物流」三張卡。他選得準、回得快,很適合接住大量重複工作。但如果卡片換了位置,他就改選物流;或真正需要的類別根本不在桌上,他仍硬挑一張,原本的正確率便漏掉了重要風險。
論文所說的 System One 決策模型,接收狀態、問題與有限的候選結果,回傳可供程式使用的結構化預測。它與靠長篇推理產生答案的 System Two 參考模型形成對照。這是本研究的操作性分類,不宜直接當成人類快思慢想的完整對應;要補機制,可先讀 System One 決策模型的有限選項介面。
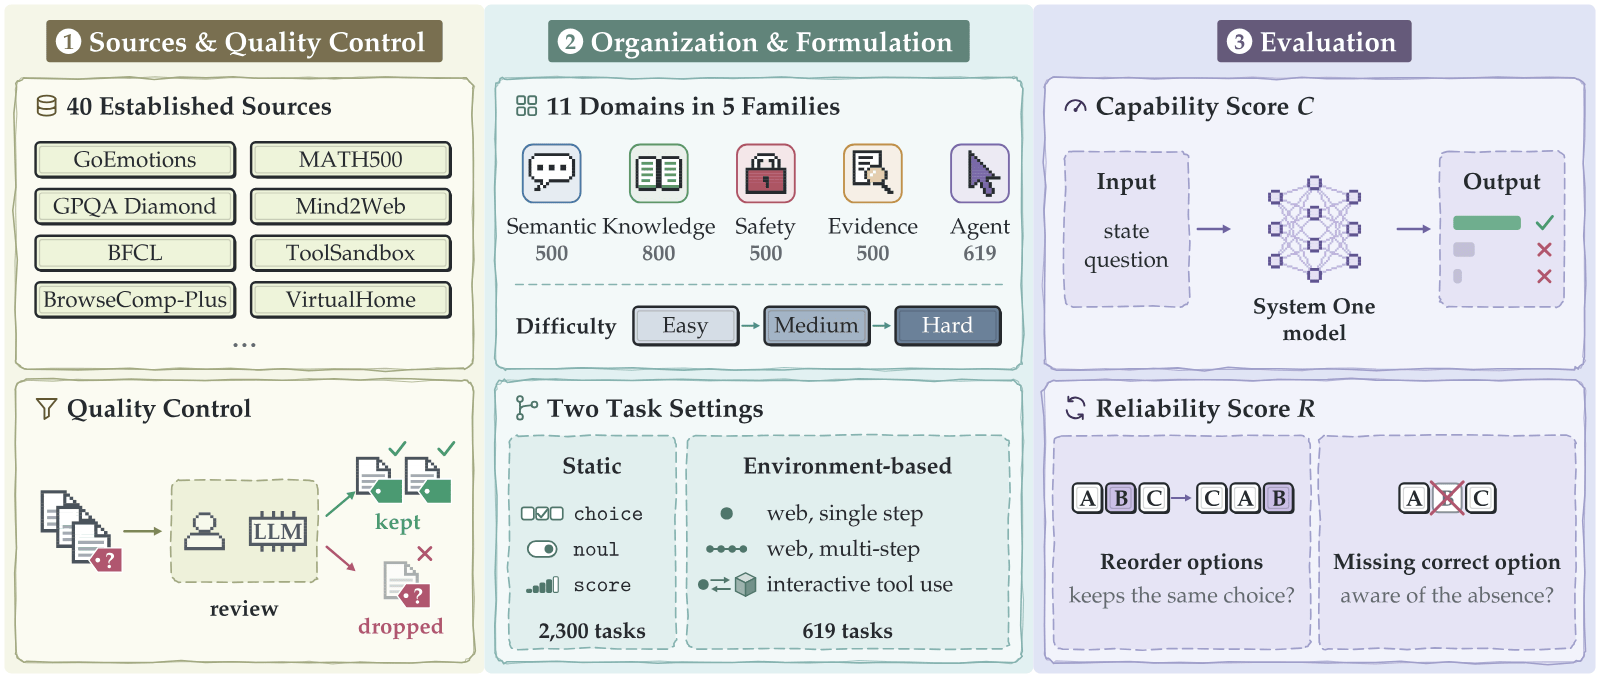
作者把 2,919 個任務分成 11 個領域、五個能力家族,涵蓋語意理解、知識與推理、安全與政策、證據判讀、代理任務完成。其中 2,300 個是靜態任務,另外有 282 個工具使用回合與 337 個文字網頁任務。任務來自 40 個公開來源,作者依模型可見資訊檢查參考答案,也讓部分動作在模擬環境執行。
二、兩個總分:會答題,與換了考卷仍站得住
能力分數 C 並非把 2,919 題全混在一起算命中率。依 作者公開的計分說明,排行榜使用 1,232 個任務:有難度分級的領域取最高級,數學取 Hard 加 Very Hard,兩個未分級領域取全部;先在各領域平均,再讓 11 個領域等權。因此,一個任務量較小的領域,也能對總分產生相同權重的影響。
可靠性 R 則把兩項不同的診斷合在一起。第一項 S,是選項順序穩定性:同題保留原始排列,再做 12 次重排,追蹤被選中的答案內容,而非 A、B、C 的位置;扣除隨機一致的基準後,得到穩定分數。
S measures consistency, not correctness.
中文:S 衡量一致性,而非正確性。
SO-Arena v1,Section 3.3.2
第二項 N,是缺少正確選項的辨識能力。同一題做兩份,一份保留正解,另一份拿掉正解;模型估計「至少有一個選項正確」的機率,再反過來看缺答訊號能否把兩份題目區分開。作者用 AUC 衡量排序辨識能力,並換成 N=2×AUC-1;它不是「拒答成功百分比」,也沒有直接指定部署時的拒答門檻。
最後,當 S 與 N 都高於隨機基準,R 取兩者乘積的平方根;否則設為零。這個設計讓兩個弱點不容易互相掩蓋:反覆選同一個錯答案可以很穩定,但缺答辨識仍可能很差。可靠性有價值,仍須與答對的能力一起看。
三、SO-Arena「第一變第七」:誰在比,分母是什麼?
the best-performing System One model ranks only seventh in reliability.
中文:能力表現最佳的 System One 模型,可靠性只排第七。
SO-Arena v1 摘要節錄
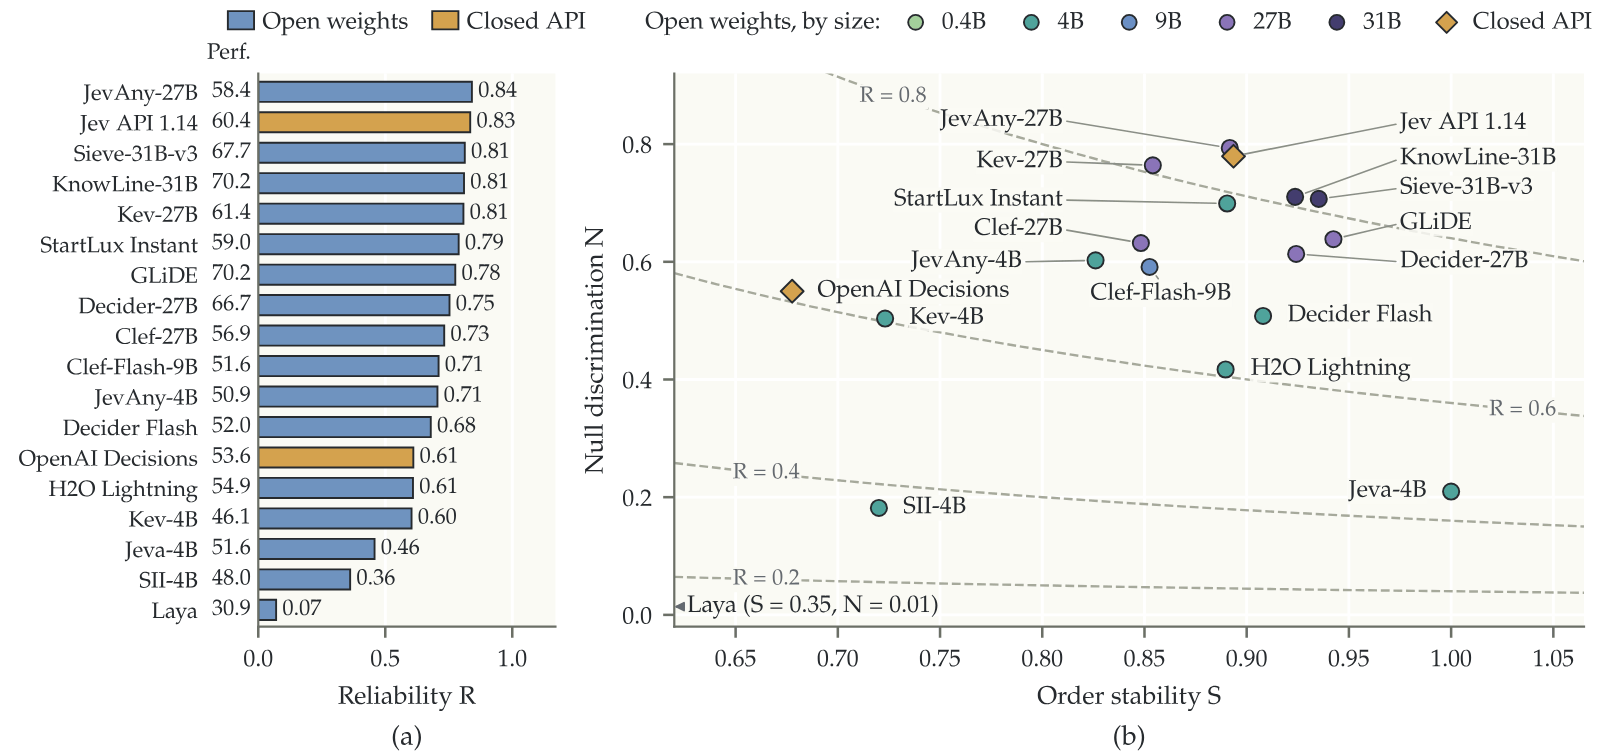
這句話的對象是 GLiDE。論文總共評估 21 個模型,但 Figure 6 的綜合可靠性比較涵蓋 18 個 System One 模型;兩個 System Two 參考模型,以及會自動切換思考模式的 StartLux Auto,不在這張 18 模型比較裡。「第七」要放在這個集合解讀。
| 作者報告的模型 | 能力分數 C | 順序穩定 S | 缺答辨識 N | 可靠性 100R |
|---|---|---|---|---|
| GLiDE | 70.21 | 0.9424 | 0.6384 | 77.57 |
| JevAny-27B | 58.37 | 0.8917 | 0.7934 | 84.11 |
上表依 作者網站公開資料 與 論文可靠性數值檔 四捨五入。GLiDE 能力較高,順序也更穩;JevAny-27B 的缺答辨識較高,因而取得更高的綜合可靠性。這是兩種能力交換位置的例子,不能由此宣稱 JevAny-27B 適合所有工作。
還有一個日期差異:專案網站 於 11 月 13 日另加入 Gemini Decision 1,並明記為論文之後的評估。因此,現在的互動網站與 11 月 11 日的 21 模型論文,成員並不完全相同。本篇不把新增模型倒填成原始論文的樣本。
四、這個疑問有外部證據,但不是本次名次的獨立重現
選項順序敏感並非這篇論文才提出的現象。Pezeshkpour 與 Hruschka 在 NAACL 2024 Findings 的原始研究 中,測試既有語言模型在選項重排後的表現差異,討論不確定答案與位置偏誤的關係。這支持「應另測順序影響」的研究動機,但不能替 2026 年這批模型的數值背書。
Tam 等人在 ACL 2025 Findings 的原始研究 則用 MMLU 與 28 個語言模型,檢查「以上皆非」作為正解時的表現與信心。它同樣提醒:會在現成答案裡挑出一個,與判斷整份答案集合不適用,是不同考驗。兩份研究的模型、題目與測法均不同於 SO-Arena,適合用來理解問題脈絡。
若你讀過 Gemini Decisions API 的機率校準分析,可以把問題再拆一層:校準問的是「報這個機率時,實際有多常答對」;SO-Arena 的 N 問的是「缺答題能否排出更高的缺答訊號」。排序辨識、機率校準與採取行動的門檻,應各自交卷。
五、AlphaLab 的判讀:把可靠性拆開,是進步的起點
我同意:缺答辨識值得單獨驗收
有限選項讓程式很好接線,也容易把「答案一定在這裡」偷偷寫成前提。真實分流時,需求可能超出類別、工具清單可能漏了必要動作,資料也可能不足。若只在正解永遠在場的題目上驗收,便測不到模型能否指出前提失效。SO-Arena 把這個缺口變成可比較的測試,是它最有用的貢獻。
我存疑:一個 R,還不足以決定交出多少權限
依 作者可靠性程式說明,S 使用 939 題,N 的主要計分使用數學、科學推理、知識與常識共 597 題;這些來自靜態選擇題,並非把整套互動代理回合逐一做相同缺答測試。作者也讓部分有原生 Null 輸出的模型,採辨識較佳的輸出格式。這有助於呈現現有介面的能力,卻提醒我們:模型間也包含介面與讀取方式的差別。
更關鍵的是錯誤代價。把一件一般工單多送一次人工處理,與錯放一個不可撤回的動作,損失不同。相同 R 可能藏著不同的錯誤組合;AUC 較高也未直接回答「門檻設多少,會漏掉幾件真正缺答案件」。選模時應保留 S、N、逐題錯誤及任務代價,而非只取最高的一格。
速度與規模的結論,也要保留實驗條件
作者觀察到,較強骨幹與額外思考的收益依領域而異,尤其多步推導與直接語意判斷的需求不同。這支持先按工作分類,再分配快慢模型。骨幹比較同時涉及模型大小與世代,不能把全部增益都歸因於參數量。
延遲比較也有條件:開放權重模型的測量在單張 H100 上、每次一題,封閉 API 則包含網路與供應商排隊時間。因此,本篇不把作者量到的速度差改寫成你在任何設備或服務上都能拿到的倍數承諾。對日常使用者,更有意義的是正確完成一次工作所花的總時間,包含重試與接管。
六、下一次選模型,先給排行榜加兩欄
不必今天就重跑整份基準。先從你已有授權、可以安全測試的小任務取一批固定題,寫出答案與錯誤代價;保留測試題,避免看完失敗才修改規則。以下是採用評估的建議,並非本文已完成的模型實測。
- 原題:記錄答案內容、是否正確、耗時與版本。
- 換位置:保留選項內容,只換順序,另記改答案與改錯答案的比例。
- 拿掉正解:先確認剩下的選項確實都不適用,再看模型能否要求補件或轉人工;別把單純 API 拒絕混成缺答辨識。
- 回到工作:用保留題比較錯放、誤攔與人工負擔,再選門檻與接管路徑。
需要把考卷變成持續回歸檢查,可接著讀 AI Evals 入門;想練習分開記錄改善與退步,可參考 WikiTrace 的配對對照。要接入工具流程,再把停止條件與回查證據一起設計。
SO-Arena 最有價值的提醒,是把「答對」之外的前提攤開來測。下一次看到高分模型,先挑一題換位置,再挑一題拿掉正解。能把這兩次失敗留下、說清楚交給誰處理,你才多了一份值得採取行動的證據。
接著閱讀
左右滑動查看更多推薦
 內容類型:文章
【2026 最新】Unsloth Dynamic 3.1 值得重下載嗎?Qwen3.8-27B 逐檔更新與量化選型教學
同一個 GGUF 檔名與容量,也可能換了內容。核對 22 個 UD 量化檔的版本差異,學會固定 revision、比對 SHA-256,並用同條件繁中考卷決定保留或更新。
閱讀文章 內容類型:文章
Edge0-145B 解讀:單卡大模型的速度、平台與授權邊界(2026)
145B 大模型能在個人電腦跑,還要看是哪份權重、哪條引擎路徑。從 Qwen 與 Strata 血統、官方記憶體與測速條件,到 Mac 發布落差,判讀這次本機 Agent 的可用邊界。
閱讀文章 內容類型:文章
Inkling 2 Small 權重開放:Apache 2.0 交付後,自架要接管什麼?(2026)
Inkling 2 Small 已交付可下載權重。從官方檔案、Apache 2.0、500GB 顯存要求的適用範圍,到 vLLM、SGLang 與量化路線,判斷誰值得接手部署。
閱讀文章 內容類型:文章
【2026 最新】SteerDistill 教學:量化 Agent 怎麼找回走錯的一步?用 CPU Trace 分清救援與學會
老師扶著做對,和學生自己會做,是兩場考試。用三種 CPU Mock 讀懂第一個偏離,分開局部修正、整題成功與無提示驗收。
閱讀文章 內容類型:文章
【2026 最新】Deletion Tuning 是什麼?學會配對小模型 Mask、三組對照與撤回
刪掉少量權重,為什麼能改善任務?從學得的二元開關出發,核對 Qwen 0.5B 與現成 Mask,建立原版、修改版及乾淨重載三組對照,分清能力增益、保留與成本。
閱讀文章 內容類型:文章
Gemini 4 Hydrogen 解讀:四種思考檔位,怎麼看速度、成本與 Agent 成績?(2026)
Hydrogen 的快,來自模型、思考深度,還是整套 Orchestrator?拆開 Google 自報的 19% 與 24%、百萬共用視窗及外部評測,判斷哪種配置值得先試。
閱讀文章