
2026 年 11 月 16 日,Jiajun Fan、Ge Liu 等研究者在 arXiv 發布〈Language Models Can Rewrite Their Own Weights〉,提出一個很直接的問題:AI 自我改寫權重,能否把改善留下來,而不必每次回答都重新多想一輪?本文依 11 月 18 日修訂的 v2 解讀;這是研究預印本,不是 11 月 20 日才發表的新論文。
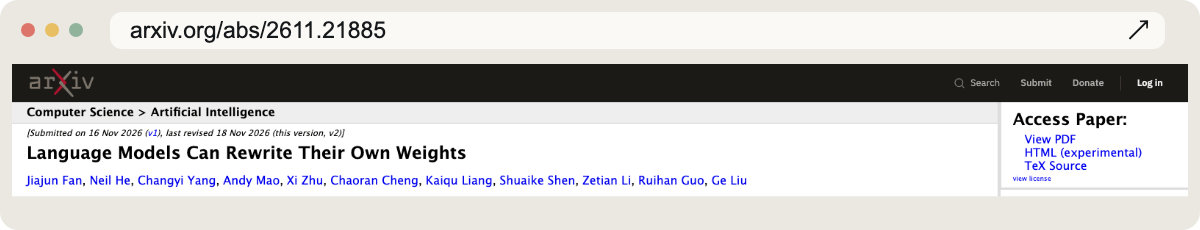
作者報告,Qwen3.5-27B 直接修改自己的參數後,在一組保留數學題上的平均答對率由 57.2% 升至 63.8%,增加 6.6 個百分點。這個結果值得注意,但兩個細節會改變你對它的理解:八場實驗每場都從基礎權重開始;修復實驗中,負責想辦法的是正常模型,修的是損壞副本。下面先看它如何修改、再拆開測試分母,最後判斷這份證據離持續自我改進還有多遠。
一、AI 自我改寫權重:把診斷變成參數修改
the model is its own optimizer.
中文:模型自己擔任最佳化者。
原文摘要
權重是模型運算時使用的大量數值。一般微調會用資料計算誤差,再沿著梯度更新這些數值;這份研究改走另一條路:讓模型讀取失敗回答與內部狀態,寫出 Python 程式,直接替換它認為有問題的參數,再比較修改前後的表現。
這裡的「不用訓練」有明確範圍:修改階段不計算梯度、不執行梯度最佳化器。模型本身已經受過預訓練與後訓練;研究者也提供有標準答案的練習題、數值工具、可讀寫的權重副本及測試介面。把它理解成「沒有反向傳播的參數搜尋」較準確,不能延伸成沒有資料、回饋或工程環境。
一次 session 裡,負責寫程式的模型維持原本權重;它呼叫的測試才套用當下修改。因此「自己」指同一款模型能提出針對自身參數的修正,不是正在思考的實例每寫一行程式,就立刻換掉自己的腦袋。若想拆清模型與外層工具的分工,可接著看 Agent Harness 是什麼。
這也有研究脈絡。Rikiya Takehi 等人在 11 月 2 日公開的 Weight-Space Programming 原始文章,已讓較強模型用程式修改較小模型的權重。這次推進的重點,是把診斷與修改交給同一款被評估的模型。前例支持這條路值得探索,並不等於獨立重現了這次 27B 的數字。
二、AI 自我改寫權重的 6.6 個百分點量到什麼?
最醒目的結果來自第二套流程的第 8 場實驗。依 原文表 13,作者在 490 道沒有提供給修改場次的保留題上,讓原版與修改版各回答每題 8 次,每次最多 16,384 個 Token,並配對使用相同種子。57.2% 與 63.8% 是這些回答的平均答對比例,不是「八次只要成功一次」的 pass@8。
相減是 6.6 個百分點;若換算相對增幅,約是 11.5%,兩個單位不能混用。作者按「題目」聚合差異做統計檢定,回報增幅的 95% 區間為 5.0 至 8.1 個百分點。每題抽樣八次增加了觀測量,卻沒有把 490 道題變成 3,920 道彼此獨立的新考題。

另一個分母藏在評分規則裡:思考過程若到上限仍未結束,即使中途寫出正確數字,也不計為答對。第 8 場修改後,撞到 Token 上限的回答由 33.6% 降為 26.1%。因此,結果與「讓既有解題過程更常成功收尾」相符;還不能把全部增幅歸因於獲得全新的數學能力。
最大增幅的修改也比想像中簡潔:它把全部 48 個線性注意力層的 time-step bias 各加 0.5。依公開 Qwen3.5 實作 的狀態更新公式,其他條件不變時,這會加快狀態衰減;作者將較少卡住的現象連到這個方向。至於原文另一個「第 8 層、移除一小部分狀態方向」案例,屬於第一套流程,保留題增幅是 1.1 個百分點,不能拿來當成 6.6 的同一套修改。
「保留」也需要讀得精確。題目來自與練習集相同的 DeepScaleR 資料池;作者在附錄 D.3 承認,490 題排除逐字重複後,仍有 8 題與練習題換句話說但數字、答案相同,並回報移除後主要結果仍顯著。這支持修改場次以外的同來源泛化,並不證明題目從未出現在模型預訓練中。
三、八場持續上升,為什麼還不是八代遞迴進化?
Every session starts from the base weights;
中文:每一場都從基礎權重開始。
原文附錄 E.9
第二套流程還多一道提交前檢查:研究者另留一批修改場次無法讀取或使用的練習題,由外層程式測試模型保留的修改,再把結果交回模型,讓它決定提交或撤回。這批題與最終的 490 道保留題分開;前者協助篩選候選,後者用來評估選出的修改。這也說明,自我改寫仍然依賴研究者設計的回饋與檢查環境。
這句是理解整篇論文的關鍵。八場中有五場撤回;三場提交的修改,在同一保留題測試上分別得到 57.8%、61.3%、63.8%。在作者展示的使用順序裡,每次提交就以該場的修改版取代先前版本,撤回時維持原狀,因此「在用模型」的曲線一路不下降。第一場的小幅增益沒有通過其顯著性門檻,第二與第八場則有。
新場次不是由上一場改好的模型接手,修改也不是八次疊加。目前展示的是:相同基礎模型反覆做有回饋的搜尋,這個順序中的後續候選更好。要驗證遞迴式自我改進,下一個關鍵實驗應讓改良後的模型負責下一輪,檢查它是否更會找修正、增益能否持續,以及累積副作用是否變大。原文把進一步輪次也列為後續方向。
這不會抹去現有結果的價值。能寫修改、測修改,並願意撤回失敗候選,本身就是比隨機擾動參數更完整的研究行為。但「找到有效修改」和「改良版越來越會改良自己」,是兩個需要不同證據的命題。當 AI 開始打造 AI 談的是更廣的研發回饋鏈條,也應保留這種分層。
四、修復影像能力:70.2% 與「恢復 83%」差在哪?
第二條證據來自人工故障。研究者把一個 MLP 輸出矩陣的連續 8 列換成很強的雜訊;正常的 Qwen3.5-27B 負責診斷並寫修復程式,測量對象則是那份損壞副本。它找出異常矩陣,將極端權重截到依矩陣數值分布決定的邊界。這與「已失去推理能力的模型自己想出救法」有重要差別。
作者說,工具回傳的是損壞權重,並經程式紀錄稽核,未見修復場次讀取正常權重檔案。這項修復是抑制雜訊,不是把遺失數字逐一還原。200 道保留數學題上,完整修復使答對率從 0% 回到 33%,原版為 58.5%;研究者另外只留下異常矩陣那部分修改,則達 55%。這個拆解也顯示,模型一併改動其他矩陣,反而拖累完整方案。

修復策略在文字數學題上找到後,作者另取六個影像測試集各 100 題、每題回答一次。合計答對率由損壞時的 7.3% 回升到 70.2%,正常模型是 84.3%。70.2 ÷ 84.3 約為 83%,所以「恢復到原本準確率的 83%」不是「準確率達 83%」。
這份證據支持:壓制某個人工注入的故障,可以讓文字以外的功能一起回來。它沒有同時建立「未損壞模型的那套自我改進,也會改善所有影像任務」。故障修復、自然能力提升,以及更廣的任務轉移,應分開記帳。
五、AlphaLab 的判讀:有效修正值得重視,優勢還要多一組對照
我同意:把改善寫進權重,改變了成本發生的位置
當修改已經選好並保存,部署時可以直接載入改過的參數,不必為了套用這份修改,在每一道題外再跑一次搜尋迴圈。這與 Inkling 2 Mini 重用固定權重增加推論深度 是不同機制。作者稱產生最大增益的場次用單張 GPU、花數小時;尋找、淘汰與驗收修改仍要算力,後續每答的輸出長度也可能改變。
因此,合理的經濟問題是:一次搜尋與回歸測試的成本,能被多少後續任務攤回來?若工作只做幾次,額外準備未必划算;若同一故障每天浪費大量推論,把修正保存在模型裡就可能有價值。「沒有新增每題搜尋流程」不能寫成「沒有成本」。
我存疑:先調好解碼,還剩多少額外收益?
截至 11 月 22 日,Qwen3.5-27B 官方模型卡 的 thinking 模式建議,包含一般任務 temperature 1.0、presence penalty 1.5,並說明可藉調整 presence penalty 減少無止境重複。論文則採 temperature 0.6,練習與保留測試的 Token 上限也與官方一般建議不同。
在本文核對的評測表裡,對照是相同解碼條件下的原版與改版,尚未交出「官方建議的重複控制」與「改權重」之間的直接比較。這不表示官方設定一定能消除增幅,也不表示作者刻意壓低基線;它表示同條件下改版勝過原版,與改版勝過其他可用處理方式,仍是兩個問題。下一份結果若補上這組對照,採用價值會更容易判斷。
我也保留:單一家族的尺寸差異,還不是通用門檻
作者測試 Qwen3.5 的 2B、4B、9B、27B,這些有限場次中,只有 27B 找到有效自我修改;小模型沒有完成修改,或其修改傷害表現。這是值得追的尺寸訊號,卻不能推成「低於 27B 都做不到」的定律。尤其 27B 的成功案例還包含較短的練習輸出預算與第二套檢查流程,跨尺寸推論需要更多重跑與一致預算。
原文的長期想像是讓模型在工作之間持續改進,甚至由機器人的環境回饋驅動修正。我同意它打開了一個有意義的實驗方向;我存疑的是,把這個方向直接當成已兌現的終身學習。安全與一般能力也必須隨版本重新量測:參數改動能減少一種失敗,不代表其他能力自動被保住。
六、下一步怎麼看:追蹤三份更有分量的證據
第一,追真正接棒的多輪實驗:改良版是否親自提出下一份修改,並在新的保留題上繼續獲益?第二,追公平的替代方案:把官方解碼設定、合理輸出預算與權重修改放進同一張成本與品質表。第三,追完整回歸:除了同來源數學題,也測語言、程式、長文與安全行為,並保留失敗候選與可回退版本。
若你負責模型評估,可以先把這三個問題寫進驗收表,而不是直接讓正式服務自動換權重。先固定基礎版本、題組與成功標準,再保存每個候選的差異及測試結果;AI Evals 入門 能補上這套工作需要的評分思路。對一般讀者而言,下次看到「AI 自我改寫權重」,先問一句:這次變好的是答案收尾、故障修復,還是改良自己的能力?回答不同,突破的含義也不同。
接著閱讀
左右滑動查看更多推薦
 內容類型:文章
【2026 最新】Depth Pro 2 教學:照片怎麼核對公尺?六步檢查距離與影片閃爍
從一張照片與一段靜止短片開始,保存公尺數值、核對 ROI 距離,再用固定色階看影片變化。六步建立可回查的深度模型研究紀錄。
閱讀文章 內容類型:文章
Depth Pro 2 論文解讀:清晰與穩定能兼得嗎?速度、尺度與授權一起看(2026)
Apple 發布 Depth Pro 2,試圖同時改善深度邊緣與影片穩定性。拆開作者評測、B200 串流速度與研究用途授權,判斷公開權重離實際採用還需要哪些證據。
閱讀文章 內容類型:文章
Qwen4-Max 正式發布:官方 62% 成本降幅,離真實工作有多遠?(2026)
Qwen4-Max 正式版新增架構與效率證據。拆開官方 Work360 的 62% 任務降本、API 單價與 Token 用量,再對照獨立評測、長程 Agent 與科學展示,判斷哪些進步能支持真實選型。
閱讀文章 內容類型:文章
【2026 最新】Unsloth Dynamic 3.1 值得重下載嗎?Qwen3.8-27B 逐檔更新與量化選型教學
同一個 GGUF 檔名與容量,也可能換了內容。核對 22 個 UD 量化檔的版本差異,學會固定 revision、比對 SHA-256,並用同條件繁中考卷決定保留或更新。
閱讀文章 內容類型:文章
【2026 最新】Deletion Tuning 是什麼?學會配對小模型 Mask、三組對照與撤回
刪掉少量權重,為什麼能改善任務?從學得的二元開關出發,核對 Qwen 0.5B 與現成 Mask,建立原版、修改版及乾淨重載三組對照,分清能力增益、保留與成本。
閱讀文章 內容類型:文章
Qwen4-Max 預覽解讀:百萬 Token、限時退役與選型的證據界線(2026)
Qwen4-Max 預覽開放百萬 Token、多模態與工具能力,卻限定 Token Plan 並將退役。讀懂互動用途限制、推理與答案共用預算,讓短期試用留下可比較的證據。
閱讀文章